Mesmo no dia em que a empresa se desfez no ar, os pedidos de correção de bug continuaram chegando
Seis meses depois de entrar na empresa, no dia em que a organização se desfez por causa da situação da companhia e só o nosso time ficou de pé, o escritório era um caos. Meu líder me disse: “Eu já não entendo muito bem a parte técnica, então agora você vai ter que cuidar de tudo”, e me passou autoridade total sobre a gestão da infraestrutura.
Mesmo em meio àquela confusão, o telefone não parava de tocar. Era um cliente. “Com licença, está acontecendo um erro na página de login. Por favor, corrijam isso rápido.”
Minha mente ficou em branco. Antes, se eu corrigisse localmente e desse um simples git push, o Jenkins ou o GitLab no servidor de outro departamento fariam o deploy automaticamente para o servidor de produção. Mas essa ligação tinha sido rompida.
Agora não existia mais nenhum “robô de deployment” para me ajudar. Eu tinha de levar esse código até o servidor de produção com as minhas próprias mãos. Era sufocante. Mas, naquele momento, o conhecimento que eu tinha adquirido nos últimos meses, batendo a cabeça e aprendendo do jeito difícil, passou pela minha cabeça.
“Espera, calma. Se eu entender o princípio, também consigo fazer isso manualmente. Vamos levar tudo com segurança, passo a passo.”
Git e GitLab: o repositório do código
Primeiro eu precisava reconstruir a ponte que tinha sido cortada. As primeiras coisas de que eu precisava eram “Git” e “GitLab”.
- Git: a ferramenta que guarda o meu código e gerencia as versões, ou seja, o histórico. (Uma máquina do tempo)
- GitLab: uma plataforma que, além da função de repositório Git, reúne em um só lugar também as ferramentas de automação de deployment (CI/CD).
“Normalmente as pessoas não usam mais o GitHub?” Sim, isso é verdade. No uso mais comum, GitHub, com GitHub Actions, é o mais popular, e alguns times também montam separadamente o tradicional peso-pesado, o Jenkins.
Mas nós estávamos em um ambiente interno fechado, com acesso externo restrito, então o GitLab Self-Hosted, que podíamos instalar diretamente no nosso próprio servidor, era a melhor escolha. As ferramentas podem ser diferentes, mas a essência é a mesma: guardar o código e fazer o deployment automaticamente.
Virei a noite instalando o GitLab no servidor e migrando o código.
“Ufa, agora se eu der push de novo, vai fazer o deploy, certo?”
Animado, modifiquei o código e mandei git push origin master. O código subiu direitinho para o repositório do GitLab. Mas o servidor de produção não se mexeu. Não importava quanto tempo eu esperasse, a funcionalidade não era atualizada.
A luta do deployment manual: reencontrando o processo perdido
“Ué? Por que isso não está sendo implantado?” Não havia nenhum sênior para eu perguntar, nenhum líder em quem eu pudesse me apoiar. Eu precisava encontrar a resposta sozinho.
Quanto mais eu pensava, mais estranho parecia. O GitLab é apenas uma “biblioteca que armazena código”. Só porque um livro novo chega à biblioteca não significa que ele vai aparecer automaticamente na prateleira da livraria, isto é, no servidor de produção. Antes, havia algo no meio fazendo essa entrega.
“Então sou eu que vou ter de fazer essa entrega?”
Comecei a percorrer o processo de deployment manual passo a passo. Era muito mais complexo e irritante do que eu imaginava.
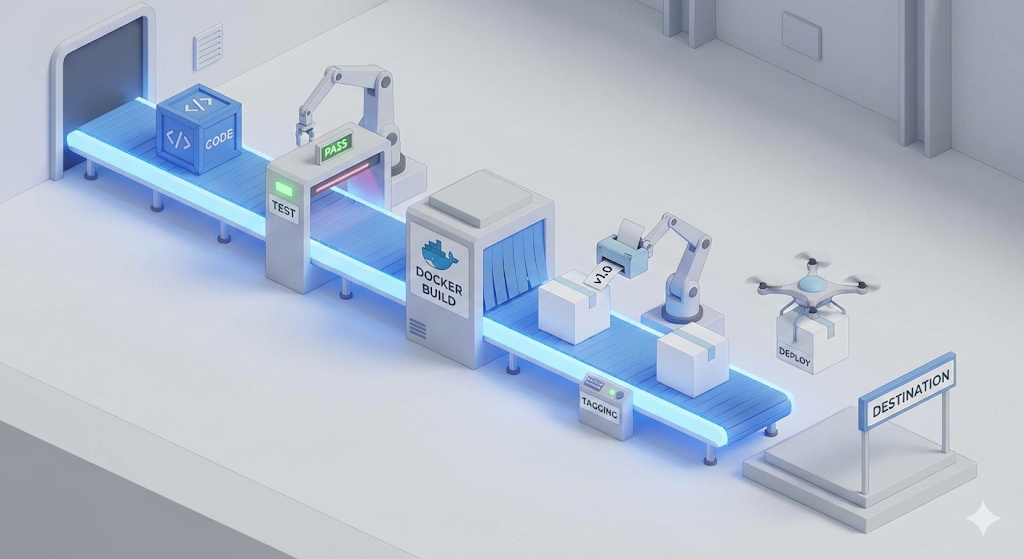
Etapa 1: teste e build (Test & Build) – filtrar produtos defeituosos
A primeira coisa a fazer era verificar se o código Java no meu computador estava correto e transformá-lo em algo executável. Não bastava copiar os arquivos. Eu precisava confirmar se o código que alterei não tinha quebrado a lógica existente, test, e se não havia erros de sintaxe, build.
Abri o terminal e digitei o comando: ./gradlew test clean build
Apareceu uma mensagem com marcas verdes dizendo que todos os testes tinham passado. Ainda bem. E se um erro tivesse aparecido aqui? Então seria um “produto defeituoso”. Um código assim não deveria subir para o servidor. Esse processo era o “primeiro dispositivo de segurança”, aquele que verifica se o código atende aos requisitos mínimos.
Etapa 2: criação de imagem (Dockerize) – congelar o ambiente
Agora eu precisava enviar esse arquivo jar para o servidor. Bastaria mandar apenas o arquivo? Não. A série “Works on My Machine” tinha me ensinado de forma dolorosa que o ambiente do meu computador, Java 17, e o do servidor, Java 8, poderiam ser diferentes. Por isso decidimos “congelar o ambiente inteiro” e enviá-lo junto. É exatamente para isso que existe o Docker.
Criei um Dockerfile na raiz do projeto e o escrevi com naturalidade.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Depois assei a imagem. docker build -t my-app:v1 .
Meu código agora tinha se tornado uma “imagem de contêiner” imortal, que rodaria da mesma forma em qualquer servidor. O Docker era o “segundo dispositivo de segurança”, que evitava erros causados por diferenças de ambiente.
Etapa 3: transporte (Push & Pull) – usando um armazém compartilhado
A imagem estava pronta. Agora eu precisava levá-la para o servidor de produção. Felizmente, o “Docker Hub” não era um servidor interno da empresa, mas um serviço externo na internet, ou seja, SaaS. Quando a empresa se desfez, a ligação com o GitLab dentro da rede interna foi cortada, mas o caminho para a rede externa continuava aberto.
Com as mãos tremendo, enviei a imagem para o Docker Hub, o armazém logístico compartilhado.
- Upload a partir do meu computador:
docker push my-id/my-app:v1
Pouco depois, apareceu a mensagem de upload concluído. Agora era hora de me conectar ao outro lado, o servidor de produção. Não correndo até a sala de servidores, mas por meio de uma conexão remota segura com “SSH (Secure Shell)”.
ssh user@production-server
Na tela preta da CLI, baixei a imagem que tinha enviado antes. docker pull my-id/my-app:v1
Etapa 4: deployment (Run) – substituir
Finalmente, a última etapa. A versão antiga do servidor já estava rodando. Eu precisava pará-la e subir a nova. Os comandos de Linux saíram da ponta dos meus dedos.
- Parar e remover o contêiner antigo:
docker stop my-app && docker rm my-app - Executar o novo contêiner:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Assim que apertei Enter, apareceu um hash comprido e, quando verifiquei os logs com docker logs -f my-app, surgiu o conhecido logo do Spring. Então o cliente ligou de novo. “Ah? Agora está funcionando bem. Obrigado!”
Mas, no fim, as pessoas erram
Aquele primeiro deployment manual foi um sucesso. Eu fiquei cheio de confiança. “Ora, então até sozinho dá para fazer.” Mas essa arrogância não durou muito. Em tarefas manuais repetitivas, os limites humanos aparecem rapidamente.
Crise 1. Um bug encontrado numa ponte estreita (a ausência de branches no Git)
Alguns dias depois, eu estava ajustando a “funcionalidade de login” para o cliente A quando, de repente, o cliente B entrou em contato dizendo que tinha surgido um bug crítico na “funcionalidade de pagamento” e que ele precisava ser corrigido imediatamente.
Entrei em pânico. Eu usava Git, sim, mas, com a desculpa de que desenvolvia sozinho, fazia todo o trabalho em uma única branch master. O código já estava um caos misturado com as mudanças da funcionalidade de login.
“Espera? Se eu corrigir só o bug de pagamento e fizer o deploy nesse estado, o código inacabado de login também vai subir, não vai?”
No fim, tive que recorrer a um método primitivo: fazer backup do código em que eu estava trabalhando em arquivos temporários e voltar atrás com git reset. Nesse processo, ainda provoquei um desastre ao perder parte do código por engano.
Crise 2. Eu não tenho colegas (a ausência de código de teste)
Depois de muito sofrimento, corrigi o bug de pagamento e fiz o deploy. Justo quando eu ia respirar aliviado, veio outro aviso: agora o “cadastro” não funcionava mais. Descobriu-se que, ao mexer na lógica de pagamento, eu tinha tocado em uma função compartilhada de validação de usuário.
“Ah… se alguém tivesse revisado o meu código, um Code Review, eu não teria cometido esse erro.”
Mas eu não tinha nenhum sênior para revisar meu código, nem colegas. Eu estava sozinho. Na verdade, como eu tinha feito a funcionalidade de cadastro com muita correria, nem sequer havia escrito testes unitários. Se eu tivesse tido o trabalho de escrever código de teste naquela época, a máquina teria acendido uma luz vermelha quando eu quebrei o cadastro ao mexer na lógica de pagamento.
Crise 3. “O servidor morreu!” (a ausência de tags do Docker)
E alguns dias depois veio o golpe final. Acrescentei uma funcionalidade às pressas e fiz o deploy, mas o servidor caiu com um erro de lógica de negócio assim que subiu. Ter pulado os testes voltou para me cobrar.
O cliente começou a me bombardear com ligações. “Façam rollback para a versão anterior o mais rápido possível!” Com as mãos tremendo, abri o terminal do servidor. Mas não havia nenhuma forma de voltar atrás.
Como eu achava versionamento um saco, sobrescrevia a imagem sempre usando apenas my-app:latest. Como eu não aplicava tags separadas como v1 ou v2, a imagem estável da versão anterior já tinha desaparecido. No fim, não me restou outra opção a não ser deixar o servidor parado para trás, corrigir o código de novo localmente e reconstruir tudo desde o começo. Levei 10 minutos para criar a imagem, movê-la até o servidor de produção e reiniciar o contêiner, e ainda precisei entregar um relatório escrito explicando como a queda do servidor havia acontecido.
Encerrando: o nome de todo esse processo era “pipeline”
Enquanto escrevia aquele relatório de incidente em troca de 10 minutos infernais de downtime, revi tudo o que tinha vivido nos últimos dias.
- Git Branch: o ponto de partida para isolar e gerenciar o código com segurança.
- Test & Code Review: a peneira que impede que produtos defeituosos passem para a etapa seguinte.
- Build & Dockerize: o processo de empacotar o código em um ambiente executável.
- Docker Tag & Push: o processo de registrar e guardar as versões para o caso de algum imprevisto.
- Deploy: a última etapa, que executa no servidor uma imagem segura.
Até então, eu conhecia esses processos apenas como fragmentos dispersos de conhecimento. Às vezes os pulava por preguiça. Outras vezes, porque nem sabia melhor. Mas os incidentes que vivi no trabalho real provaram que cada uma dessas etapas era um dispositivo de segurança essencial que não podia ser omitido.
E então percebi o que era, de fato, aquela “automação” que eu vinha procurando desesperadamente. Não era simplesmente uma máquina que digitava comandos por mim. Era o caminho que faz as etapas de 1 a 5 fluírem como água corrente, sem interrupção e sem erros humanos.
Isso era exatamente o pipeline de CI/CD.
“Chefe, agora eu entendi. O que precisamos é de um ‘pipeline’ em que esses dispositivos de segurança funcionem automaticamente.”
Da próxima vez, com base nesse projeto, vamos realmente construir o meu próprio robô de deployment: o pipeline de CI/CD.