Nawet w dniu, w którym firma się rozpadła, prośby o poprawki błędów nadal przychodziły
Sześć miesięcy po dołączeniu do firmy, w dniu, w którym organizacja rozsypała się z powodów firmowych i tylko nasz zespół został samotnie na placu boju, w biurze panował chaos. Mój lider zespołu powiedział: „Ja już za bardzo nie ogarniam technikaliów, więc teraz ty musisz zrobić wszystko”, i przekazał mi pełnię władzy nad zarządzaniem infrastrukturą.
Nawet pośród tego zamieszania telefon nie przestawał dzwonić. To był klient. „Przepraszam, na stronie logowania pojawia się błąd. Proszę to szybko naprawić.”
W głowie zrobiło mi się pusto. Kiedyś wystarczyłoby poprawić to lokalnie i zrobić git push, a Jenkins albo GitLab na serwerze innego działu automatycznie wdrożyłby to na serwer produkcyjny. Ale ten łańcuch został przerwany.
Teraz nie było już żadnego „robota wdrożeniowego”, który by mi pomógł. Musiałem własnymi rękami przenieść ten kod na serwer produkcyjny. To było przytłaczające. Ale właśnie wtedy przez głowę przemknęła mi wiedza, którą przez ostatnie miesiące zdobywałem metodą prób i błędów.
„Chwila, spokojnie. Jeśli rozumiem zasadę, dam radę zrobić to ręcznie. Przenieśmy to bezpiecznie, krok po kroku.”
Git i GitLab: magazyn kodu
Najpierw musiałem odbudować zerwany most. Pierwszymi rzeczami, których potrzebowałem, były „Git” i „GitLab”.
- Git: narzędzie, które przechowuje mój kod i zarządza jego wersjami (historią). (Wehikuł czasu)
- GitLab: platforma, która oprócz funkcji repozytorium Git łączy w sobie także narzędzia do automatyzacji wdrożeń (CI/CD).
„Czy zwykle nie używa się częściej GitHuba?” To prawda. Najpopularniejszy jest dziś GitHub, wraz z GitHub Actions, a niektóre zespoły stawiają też osobno tradycyjnego mocarza, Jenkins.
My jednak pracowaliśmy w zamkniętym środowisku sieci wewnętrznej z ograniczonym dostępem z zewnątrz, więc najlepszym wyborem był GitLab Self-Hosted, który mogliśmy zainstalować bezpośrednio na własnym serwerze. Narzędzia mogą się różnić, ale istota pozostaje ta sama: przechowywać kod i wdrażać go automatycznie.
Zarwałem noc, instalując GitLab na serwerze i przenosząc tam kod.
„Uff, teraz jeśli znowu zrobię push, to powinno się wdrożyć, prawda?”
Pełen ekscytacji zmodyfikowałem kod i wysłałem git push origin master. Kod poprawnie trafił do repozytorium GitLab. Ale serwer produkcyjny nawet nie drgnął. Czekałem i czekałem, a funkcjonalność się nie aktualizowała.
Męka ręcznego wdrażania: odnaleźć zaginiony proces
„Co? Dlaczego to się nie wdraża?” Nie było żadnego seniora, którego mógłbym zapytać, ani lidera, na którym mógłbym się oprzeć. Musiałem sam znaleźć odpowiedź.
Im dłużej o tym myślałem, tym dziwniejsze to było. GitLab to tylko „biblioteka przechowująca kod”. Sam fakt, że do biblioteki trafia nowa książka, nie oznacza, że automatycznie pojawi się ona na półce w księgarni, czyli na serwerze produkcyjnym. Wcześniej coś pośrodku realizowało tę dostawę.
„To co, mam to dostarczać sam?”
Zacząłem przechodzić ręczny proces wdrożenia krok po kroku. Okazał się znacznie bardziej skomplikowany i uciążliwy, niż przypuszczałem.
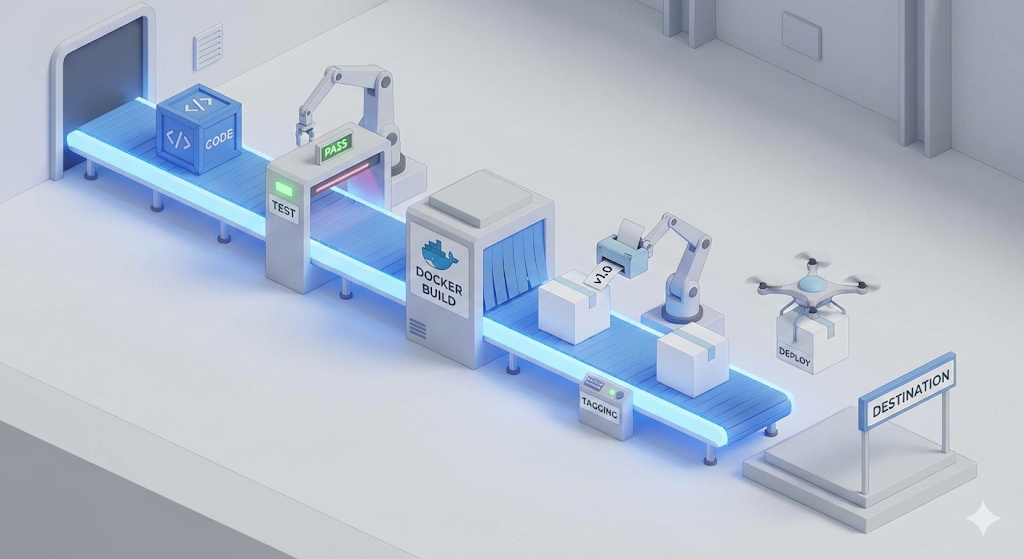
Krok 1: test i build (Test & Build) – odfiltrować wadliwe produkty
Pierwszą rzeczą, jaką musiałem zrobić, było sprawdzenie, czy kod Java na moim komputerze jest poprawny, i doprowadzenie go do stanu uruchamialnego. Samo kopiowanie plików nie wystarczało. Musiałem sprawdzić, czy kod, który zmieniłem, nie zepsuł istniejącej logiki, test, i czy nie ma błędów składni, build.
Otworzyłem terminal i wpisałem polecenie: ./gradlew test clean build
Pojawił się komunikat z zielonymi znacznikami, że wszystkie testy przeszły pomyślnie. Uff. A co by było, gdyby pojawił się tutaj błąd? Wtedy byłby to „wadliwy produkt”. Taki kod nie powinien trafić na serwer. Ten proces był „pierwszym zabezpieczeniem”, które sprawdza, czy kod spełnia minimalne wymagania.
Krok 2: tworzenie obrazu (Dockerize) – zamrozić środowisko
Teraz musiałem wysłać ten plik jar na serwer. Czy wystarczyło wysłać sam plik? Nie. Seria „Works on My Machine” boleśnie nauczyła mnie, że środowisko mojego komputera, Java 17, i środowisko serwera, Java 8, mogą się różnić. Dlatego postanowiliśmy „zamrozić całe środowisko” i wysłać je razem. Do tego właśnie służy Docker.
Stworzyłem Dockerfile w katalogu głównym projektu i napisałem go już całkiem swobodnie.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Potem zbudowałem obraz. docker build -t my-app:v1 .
Mój kod stał się teraz nieśmiertelnym „obrazem kontenera”, który zadziała tak samo na dowolnym serwerze. Docker był „drugim zabezpieczeniem”, które chroniło przed błędami wynikającymi z różnic środowiskowych.
Krok 3: transport (Push & Pull) – korzystanie ze wspólnego magazynu
Obraz był gotowy. Teraz musiałem przenieść go na serwer produkcyjny. Na szczęście „Docker Hub” nie był serwerem wewnętrznym, lecz zewnętrzną usługą w internecie, czyli SaaS. Kiedy firma się rozpadła, połączenie z GitLabem w sieci wewnętrznej zostało odcięte, ale droga do sieci zewnętrznej wciąż była otwarta.
Drżącymi rękami wypchnąłem obraz do Docker Hub, wspólnego magazynu logistycznego.
- Wysyłka z mojego komputera:
docker push my-id/my-app:v1
Po chwili pojawił się komunikat, że przesyłanie zostało zakończone. Teraz przyszła pora połączyć się z drugą stroną, czyli z serwerem produkcyjnym. Nie przez bieganie do serwerowni, ale przez bezpieczne połączenie zdalne za pomocą „SSH (Secure Shell)”.
ssh user@production-server
Na czarnym ekranie CLI pobrałem obraz, który przed chwilą wrzuciłem. docker pull my-id/my-app:v1
Krok 4: wdrożenie (Run) – podmiana
Wreszcie ostatni etap. Na serwerze działała już stara wersja. Musiałem ją zatrzymać i uruchomić nową. Polecenia Linuksa same wychodziły spod moich palców.
- Zatrzymanie i usunięcie dotychczasowego kontenera:
docker stop my-app && docker rm my-app - Uruchomienie nowego kontenera:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Gdy tylko nacisnąłem Enter, na ekranie pojawiła się długa wartość hash, a kiedy sprawdziłem logi poleceniem docker logs -f my-app, zobaczyłem znajome logo Springa. Klient zadzwonił ponownie. „O? Teraz już działa. Dziękuję!”
Ale ostatecznie człowiek popełnia błędy
Pierwsze ręczne wdrożenie zakończyło się sukcesem. Byłem pełen pewności siebie. „Co to takiego, przecież sam też dam radę.” Ale ta pycha nie trwała długo. W powtarzalnych ręcznych czynnościach ludzkie ograniczenia bardzo szybko wychodzą na jaw.
Kryzys 1. Bug spotkany na wąskim moście (brak branchy Git)
Kilka dni później poprawiałem „funkcję logowania” dla klienta A, gdy nagle klient B zgłosił, że w „funkcji płatności” wybuchł krytyczny błąd i trzeba go naprawić natychmiast.
Wpadłem w panikę. Owszem, korzystałem z Gita, ale pod pretekstem, że pracuję sam, wykonywałem całą pracę na jednym branchu master. Kod był już kompletną mieszaniną zmian związanych z funkcją logowania.
„Zaraz? Jeśli w takim stanie poprawię tylko błąd płatności i wdrożę kod, to razem z nim pójdzie też niedokończony kod logowania, prawda?”
Ostatecznie musiałem sięgnąć po prymitywną metodę: zrobić kopię kodu, nad którym pracowałem, do plików tymczasowych i cofnąć kod poleceniem git reset. W tym procesie doprowadziłem nawet do katastrofy, przypadkowo tracąc część kodu.
Kryzys 2. Nie mam współpracowników (brak kodu testowego)
Po wielu perypetiach poprawiłem błąd płatności i wdrożyłem zmiany. Gdy już miałem odetchnąć, przyszła kolejna wiadomość: teraz „rejestracja” nie działała. Okazało się, że przy poprawianiu logiki płatności ruszyłem współdzieloną funkcję walidacji użytkownika.
„Ach… gdyby ktoś spojrzał na mój kod, czyli zrobił Code Review, nie popełniłbym takiego błędu.”
Ale nie miałem ani seniora, który mógłby obejrzeć mój kod, ani współpracownika. Byłem sam. W rzeczywistości, ponieważ funkcję rejestracji tworzyłem w totalnym pośpiechu, nawet nie napisałem do niej testów jednostkowych. Gdybym wtedy, mimo że było to męczące, przygotował kod testowy, maszyna zapaliłaby czerwone światło w momencie, gdy zepsułem rejestrację, dotykając logiki płatności.
Kryzys 3. „Serwer padł!” (brak tagów Dockera)
A kilka dni później nadszedł cios kończący. W pośpiechu dodałem funkcję i wdrożyłem ją, ale serwer zawiesił się z błędem logiki biznesowej zaraz po uruchomieniu. Pominięcie testów zemściło się na mnie.
Telefony od klienta zaczęły się urywać. „Proszę szybko przywrócić poprzednią wersję!” Trzęsącymi się rękami otworzyłem terminal serwera. Ale nie było żadnego sposobu na rollback.
Ponieważ za każdym razem uznawałem wersjonowanie za kłopotliwe, nadpisywałem obraz wyłącznie jako my-app:latest. Skoro nie nadawałem osobnych tagów wersji, takich jak v1 czy v2, stabilny obraz poprzedniej wersji już zniknął. W końcu nie zostało mi nic innego, jak zostawić padnięty serwer za sobą, wrócić do lokalnego środowiska, ponownie poprawić kod i zbudować wszystko od zera. Stworzenie obrazu, przeniesienie go na serwer produkcyjny i ponowne uruchomienie kontenera zajęły 10 minut, a do tego musiałem złożyć pisemny raport wyjaśniający przebieg awarii serwera.
Na koniec: nazwa całego tego procesu brzmiała „pipeline”
Pisząc ten raport z incydentu w zamian za 10 piekielnych minut przestoju, wróciłem myślami do wszystkiego, czego doświadczyłem w ostatnich dniach.
- Git Branch: punkt wyjścia, który pozwala bezpiecznie izolować kod i nim zarządzać.
- Test & Code Review: sito, które nie przepuszcza wadliwych produktów do następnego etapu.
- Build & Dockerize: proces pakowania kodu w środowisko gotowe do uruchomienia.
- Docker Tag & Push: proces oznaczania i przechowywania wersji na wypadek najgorszego.
- Deploy: ostatni etap, w którym bezpieczny obraz zostaje uruchomiony na serwerze.
Do tamtej pory znałem te procesy tylko jako rozproszone fragmenty wiedzy. Czasem pomijałem je, bo były uciążliwe. Czasem dlatego, że nie wiedziałem lepiej. Ale incydenty, których doświadczyłem w prawdziwej pracy, udowodniły, że każdy z tych etapów jest niezbędnym zabezpieczeniem, którego nie wolno pominąć.
I wtedy zrozumiałem, czym naprawdę była ta „automatyzacja”, której tak desperacko szukałem. To nie była po prostu maszyna wpisująca polecenia za mnie. To była ścieżka, która pozwala etapom od 1 do 5 płynąć jak bieżąca woda, bez przerw i bez ludzkich pomyłek.
Tym właśnie był pipeline CI/CD.
„Szefie, teraz już rozumiem. To, czego potrzebujemy, to ‘pipeline’, w którym te zabezpieczenia działają automatycznie.”
Następnym razem, opierając się na tym planie, zbudujmy naprawdę mojego własnego robota wdrożeniowego, czyli pipeline CI/CD.