Till och med den dag företaget föll isär fortsatte buggrättningsförfrågningarna att komma
Sex månader efter att jag började på företaget, den dag då organisationen föll samman på grund av företagets situation och bara vårt team blev kvar på egen hand, var kontoret i fullständig oordning. Min teamledare sa: “Jag kan inte tekniken särskilt bra längre, så nu får du ta hand om allt”, och gav mig full kontroll över infrastrukturen.
Även mitt i all den förvirringen fortsatte telefonen att ringa. Det var en kund. “Hej, det uppstår ett fel på inloggningssidan. Kan ni fixa det snabbt?”
Jag blev helt blank i huvudet. Förr i tiden räckte det att jag fixade det lokalt och gjorde en git push, så skulle Jenkins eller GitLab på en annan avdelnings server automatiskt deploya det till produktionsservern. Men den kedjan hade brutits.
Nu fanns det ingen “deployment-robot” kvar som kunde hjälpa mig. Jag var tvungen att flytta den här koden till produktionsservern med mina egna händer. Det kändes överväldigande. Men i det ögonblicket blixtrade all den kunskap jag hade byggt upp under de senaste månaderna genom att kasta mig rakt in i problemen förbi i huvudet.
“Vänta, lugna dig. Om jag förstår principen kan jag göra det manuellt också. Vi tar det säkert, steg för steg.”
Git och GitLab: kodens lagerplats
Först var jag tvungen att bygga upp den avbrutna bron igen. Det första jag behövde var “Git” och “GitLab”.
- Git: Ett verktyg som lagrar min kod och håller ordning på versionerna, alltså historiken. (En tidsmaskin)
- GitLab: En plattform som inte bara fungerar som Git-repo, utan där även verktygen för automatiserad deployment (CI/CD) är samlade under ett och samma tak.
“Brukar man inte oftast använda GitHub?” Jo, det stämmer. Mest vanligt är GitHub, tillsammans med GitHub Actions, och vissa team sätter också upp den traditionella tungviktaren Jenkins separat.
Men vi arbetade i en sluten intern nätverksmiljö med begränsad extern åtkomst, så GitLab Self-Hosted, som vi kunde installera direkt på vår egen server, var det bästa valet. Verktygen kan skilja sig åt, men kärnan är densamma: lagra kod och deploya den automatiskt.
Jag satt uppe hela natten och installerade GitLab på servern och flyttade över koden.
“Puh, om jag gör en push igen nu så borde det väl deployas, eller?”
Förväntansfullt ändrade jag koden och skickade iväg git push origin master. Koden hamnade fint i GitLab-repot. Men produktionsservern rörde sig inte alls. Hur länge jag än väntade uppdaterades inte funktionen.
Slitet med manuell deployment: att hitta den förlorade processen
“Va? Varför deployas det inte?” Det fanns ingen senior att fråga, ingen teamledare att luta sig mot. Jag var tvungen att hitta svaret själv.
Ju mer jag tänkte på det, desto märkligare blev det. GitLab är bara ett “bibliotek som lagrar kod”. Bara för att en ny bok kommer in till ett bibliotek betyder det inte att den automatiskt dyker upp på hyllan i en bokhandel, alltså produktionsservern. Tidigare fanns det något däremellan som skötte den leveransen.
“Då måste jag alltså leverera det själv?”
Jag började gå igenom den manuella deploymentsprocessen steg för steg. Det var mycket mer komplicerat och tröttsamt än jag hade trott.
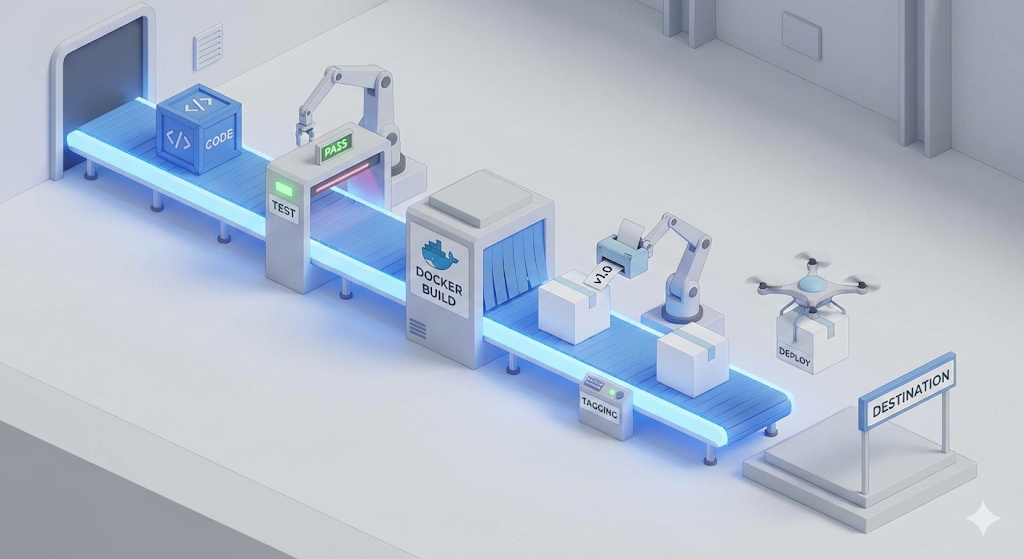
Steg 1: test och build (Test & Build) – sortera bort defekta produkter
Det första jag behövde göra var att kontrollera att Java-koden på min dator var korrekt och göra den körbar. Det räckte inte att bara kopiera filer. Jag behövde kontrollera om koden jag ändrat hade förstört den befintliga logiken, test, och om det fanns syntaxfel, build.
Jag öppnade terminalen och skrev kommandot: ./gradlew test clean build
Det dök upp ett meddelande med gröna bockar som sa att alla tester hade gått igenom. Som tur var. Och om ett fel hade dykt upp här? Då hade det varit en “defekt produkt”. Sådan kod får inte hamna på servern. Den här processen var den “första säkerhetsmekanismen”, den som kontrollerar att koden uppfyller minimikraven.
Steg 2: skapa image (Dockerize) – frysa miljön
Nu behövde jag skicka den här jar-filen till servern. Skulle det räcka att bara skicka filen? Nej. Serien “Works on My Machine” hade lärt mig den hårda vägen att miljön på min dator, Java 17, och miljön på servern, Java 8, kunde vara olika. Därför bestämde vi oss för att “frysa hela miljön” och skicka med den. Det är precis det Docker är till för.
Jag skapade en Dockerfile i projektroten och skrev den utan att tveka.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Sedan byggde jag imagen. docker build -t my-app:v1 .
Nu hade min kod blivit en odödlig “container-image” som skulle köra likadant på vilken server som helst. Docker var den “andra säkerhetsmekanismen”, den som förhindrade fel orsakade av miljöskillnader.
Steg 3: transport (Push & Pull) – använda ett gemensamt lager
Imagen var klar. Nu behövde jag flytta den till produktionsservern. Som tur var var “Docker Hub” inte en intern företagstjänst, utan en extern internettjänst, alltså SaaS. När företaget föll isär bröts GitLab-kopplingen i det interna nätverket, men vägen ut till det externa nätet var fortfarande öppen.
Med darrande händer skickade jag upp imagen till Docker Hub, det gemensamma logistiklagret.
- Ladda upp från min dator:
docker push my-id/my-app:v1
En stund senare kom meddelandet att uppladdningen var klar. Nu var det dags att ansluta till den andra sidan, produktionsservern. Inte genom att springa till serverrummet, utan genom att ansluta säkert på distans via “SSH (Secure Shell)”.
ssh user@production-server
På den svarta CLI-skärmen drog jag ner imagen jag hade laddat upp tidigare. docker pull my-id/my-app:v1
Steg 4: deployment (Run) – byta ut det gamla
Äntligen sista steget. Den gamla versionen av servern kördes redan. Jag behövde stoppa den och starta upp den nya versionen. Linux-kommandona flödade ut från mina fingertoppar.
- Stoppa och ta bort den befintliga containern:
docker stop my-app && docker rm my-app - Starta den nya containern:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
I samma ögonblick som jag tryckte Enter dök ett långt hashvärde upp, och när jag kontrollerade loggarna med docker logs -f my-app kom den välbekanta Spring-logotypen fram. Kunden ringde tillbaka. “Oj? Nu fungerar det bra. Tack!”
Men till slut gör människor misstag
Den första manuella deploymenten var en framgång. Jag blev full av självförtroende. “Vadå, det här går ju att göra ensam också.” Men den arrogansen varade inte länge. I det upprepade manuella arbetet blev mänskliga begränsningar snabbt tydliga.
Kris 1. En bugg på en smal bro (avsaknaden av Git-brancher)
Några dagar senare höll jag på att ändra “inloggningsfunktionen” för kund A när kund B plötsligt hörde av sig och sa att en kritisk bugg hade exploderat i “betalningsfunktionen” och behövde rättas omedelbart.
Jag fick panik. Jag använde visserligen Git, men eftersom jag intalade mig att jag ändå utvecklade ensam gjorde jag allt arbete på en enda master-branch. Koden var redan en enda röra av ändringar från inloggningsfunktionen.
“Vänta nu? Om jag bara rättar betalningsbuggen och deployar i det här läget, kommer då inte även den ofärdiga inloggningskoden att följa med upp?”
Till slut var jag tvungen att använda en primitiv metod: säkerhetskopiera koden jag arbetade på till temporära filer och återställa koden med git reset. Under processen orsakade jag till och med en katastrof genom att av misstag förlora en del kod.
Kris 2. Jag har inga kollegor (avsaknaden av testkod)
Efter många omvägar rättade jag betalningsbuggen och deployade den. Precis när jag skulle andas ut kom nästa besked: nu fungerade inte “registreringen” längre. Det visade sig att jag, när jag ändrade betalningslogiken, hade rört en delad funktion för användarvalidering.
“Ah… om någon hade granskat min kod, en Code Review, hade jag inte gjort ett sådant misstag.”
Men jag hade ingen senior som kunde granska min kod och ingen kollega heller. Jag var ensam. Faktum är att jag, eftersom registreringsfunktionen byggdes i sådan hast, inte ens hade skrivit några enhetstester. Om jag då, hur jobbigt det än hade varit, hade skrivit testkod, skulle maskinen ha tänt rött ljus när jag förstörde registreringen genom att röra betalningslogiken.
Kris 3. “Servern är död!” (avsaknaden av Docker-taggar)
Och några dagar senare kom det avgörande slaget. Jag lade till en funktion i all hast och deployade den, men servern kraschade av ett fel i affärslogiken så fort den startade. Att jag hade hoppat över testerna slog tillbaka mot mig.
Kundens samtal började hagla in. “Roll back till den tidigare versionen så snabbt som möjligt!” Med skakande händer öppnade jag serverterminalen. Men det fanns inget sätt att rulla tillbaka.
Eftersom jag varje gång tyckte att versionshantering var jobbigt skrev jag bara över imagen som my-app:latest. Eftersom jag inte använde separata versionstaggar som v1 eller v2 var den stabila imagen från föregående version redan borta. Till slut hade jag inget annat val än att lämna den döda servern bakom mig, gå tillbaka lokalt, rätta koden igen och bygga om allt från början. Det tog 10 minuter att skapa imagen, flytta den till produktionsservern och starta om containern, och dessutom var jag tvungen att lämna in en skriftlig incidentrapport som förklarade hur driftstoppet hade gått till.
Avslutning: namnet på hela den här processen var “pipeline”
Medan jag skrev den där incidentrapporten i utbyte mot 10 helvetiska minuter av downtime såg jag tillbaka på allt jag hade gått igenom under de senaste dagarna.
- Git Branch: Startpunkten, där koden isoleras och hanteras säkert.
- Test & Code Review: Silen som hindrar defekta produkter från att gå vidare till nästa steg.
- Build & Dockerize: Processen där koden paketeras i en körbar miljö.
- Docker Tag & Push: Processen där versionen märks upp och sparas, ifall det värsta skulle hända.
- Deploy: Det sista steget, där en säker image körs på servern.
Fram till dess hade jag bara känt till de här processerna som spridda kunskapsfragment. Ibland hoppade jag över dem för att de var jobbiga. Ibland för att jag inte visste bättre. Men incidenterna jag upplevde i verkligt arbete bevisade att varje enskilt steg var en nödvändig säkerhetsmekanism som inte fick utelämnas.
Och då insåg jag vad den där “automatiseringen” som jag så desperat hade letat efter egentligen var. Det var inte bara en maskin som skrev kommandon åt mig. Det var vägen som får steg 1 till 5 att flyta som rinnande vatten, utan avbrott och utan mänskliga misstag automatiskt.
Det var exakt det som var CI/CD-pipelinen.
“Teamledare, nu förstår jag. Det vi behöver är en ‘pipeline’ där de här säkerhetsmekanismerna körs automatiskt.”
Nästa gång ska vi, utifrån den här ritningen, faktiskt bygga min egen deployment-robot: CI/CD-pipelinen.