Mais forte que qualquer documento de requisitos: “deixa eu só dar uma olhada”
Quando me vi como único dev em um projeto de SI no setor público, o maior obstáculo não era a parte técnica. Era a ‘incerteza’. Aquele cenário ideal, com design baseado em especificações detalhadas de requisitos, simplesmente não existia. Os responsáveis pelo projeto, sem muito conhecimento de desenvolvimento, na maioria das vezes nem sabiam o que queriam até verem a tela funcionando.
“Hmm, no desenho até dá pra entender, mas… não dá pra eu clicar de verdade?”
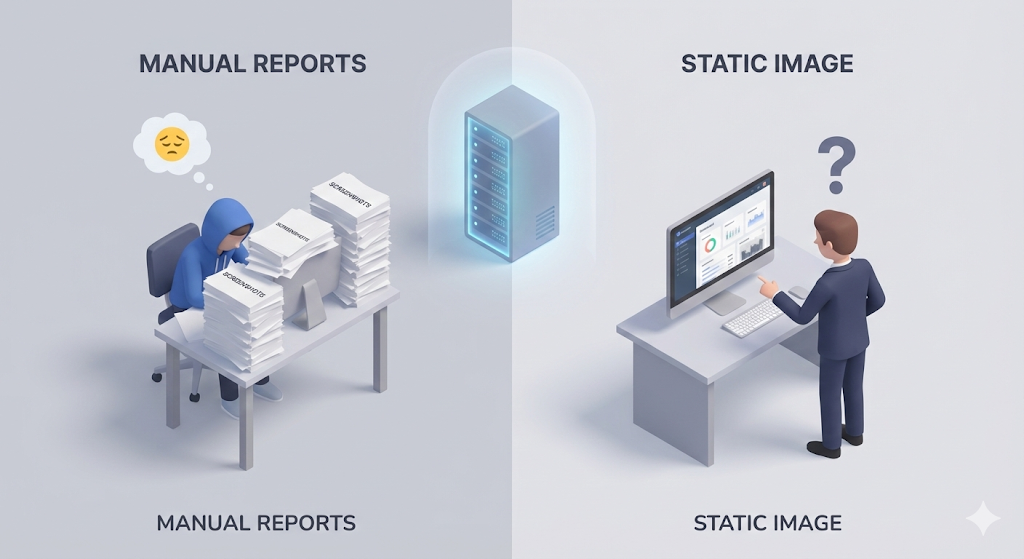
Cada vez que eu terminava uma funcionalidade, rodava localmente (no meu computador), tirava prints, anotava com caneta vermelha e mandava por e-mail um ‘arquivo de relatório (HWP/PPT)’. Mas só com fotos estáticas eu não conseguia agradar o responsável.
“Ah, aquela funcionalidade de antes era melhor. Volta ela pra mim.” “O que acontece quando eu aperto esse botão? Grava um vídeo aí.”
Ontem ele preferia A, hoje quer o B. Ajustar o código local, tirar print de novo, escrever relatório: um loop infinito. A situação ficou de cabeça pra baixo, eu gastava mais tempo escrevendo relatório do que programando.
Caiu a ficha de vez: ‘eu não preciso ficar mandando print da minha tela, preciso é de um playground (servidor de desenvolvimento) onde o responsável entre, clique à vontade e quebre o que quiser’.
A oportunidade aparece sem aviso: redescobrindo um servidor abandonado
Por sorte, durante a separação da empresa, sobrou para a nossa equipe um servidor ocioso (computador vazio). A configuração não era das melhores, mas tinha Linux instalado e um IP público conectado: um recurso e tanto.
“Chefe, posso usar esse servidor que tá sobrando? Quero montar nele um servidor pro responsável validar as coisas.”
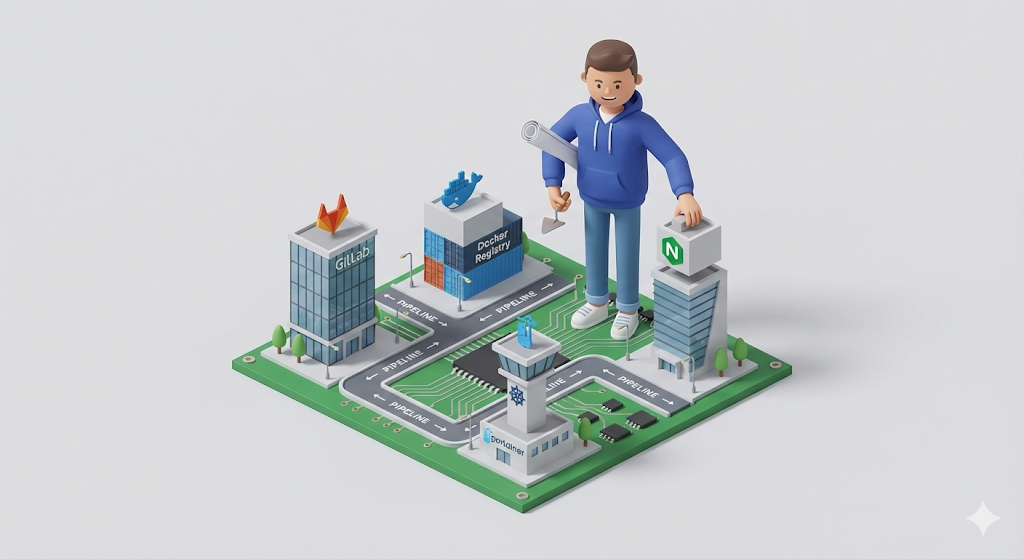
Autorização concedida. Comecei a despejar nesse servidor vazio tudo que tinha aprendido até ali, construindo o ‘meu pequeno império de infraestrutura’. Foi a consolidação de meses de luta (a saga das séries Works on My Machine & The Pipeline).
- GitLab (repositório de código): instalar um repositório privado para gerenciar o código com segurança.
- Docker Registry (repositório de imagens): criar um depósito só nosso para guardar as imagens Docker geradas no build.
- Portainer (gerenciamento de containers): deixar o Docker gerenciável por GUI, para mim, que morro de medo da CLI.
- Nginx (servidor web): colocar um porteiro que organiza o trânsito das requisições do frontend e do backend.
A solução: separação total de ambientes (Dev vs Prod)
Agora eu tinha dois palcos (servidores) à disposição. Para acomodar as mudanças de humor do responsável sem colocar o servidor de produção em risco, separei a estratégia de deploy.
- Servidor de desenvolvimento (Development): ‘o laboratório livre’
- Não dá nem tempo de o responsável perguntar “e aquilo, já ficou pronto?”.
- Quando o código sobe para a branch
develop, o pipeline roda na hora e faz o deploy automático. - O responsável acessa a URL do servidor de dev quando quiser, testa as funcionalidades e manda o feedback.
- Servidor de produção (Production): ‘o santuário validado’
- Só recebe deploy quando o responsável declara: “Fechado, a versão final é com essa funcionalidade!”.
- O código é juntado na branch
master(Merge), e o deploy só acontece se eu apertar o ‘botão de aprovação de deploy’ no GitLab (Manual).
[Code Verification] Colocando ordem com deploy condicional
O GitLab CI permite definir caminhos de deploy diferentes para cada branch. Quando essa estratégia vira código, fica assim.
stages:
  - build
  - deploy

# 1. Build (comum)
build_job:
  stage: build
  script:
    - ./gradlew build
    - docker build -t my-reg/app:$CI_COMMIT_SHA .
    - docker push my-reg/app:$CI_COMMIT_SHA

# 2. Deploy para o servidor de desenvolvimento (automatico)
# Quando o codigo cai na branch 'develop', faz deploy sem questionar.
deploy_to_dev:
  stage: deploy
  script:
    - ssh user@dev-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-dev"
  only:
    - develop

# 3. Deploy para producao (aprovacao manual)
# Mesmo que codigo entre na branch 'master', nada e deployado ate eu apertar o botao.
deploy_to_prod:
  stage: deploy
  script:
    - ssh user@prod-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-prod"
  only:
    - master
  when: manual # O ponto chave! So executa quando 'alguem aperta o botao'.
Pontos-chave:
only: - develop: a branch de desenvolvimento sempre recebe deploy automático. Aqui, velocidade é tudo.when: manual: a branch de produção ganha uma trava de segurança, em que uma pessoa confere mais uma vez antes de apertar o botão.
Para fechar: agora sim virei um ‘morando sozinho’ completo
Agora, mesmo sendo dev solo, tenho um sistema completo.
- Local: desenvolvo as funcionalidades no meu computador.
- Desenvolvimento (Dev): um
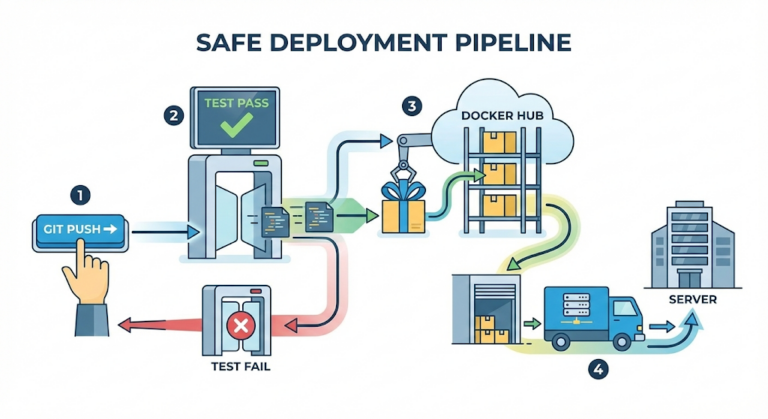
git pushe, 5 minutos depois, já está no servidor de dev. O responsável confere pessoalmente. - Produção (Prod): junto só as funcionalidades aprovadas e faço o deploy com segurança, com um clique.
Aquele eu do início, virando a noite com a ferramenta de captura aberta e anotando comentários em arquivos do Hangul, não existe mais. Quando o responsável diz “pode mudar isso aqui pra mim?”, consigo responder “claro, já corrigi e subi no servidor de dev, dá uma olhada” e tomar meu café tranquilo. É que o sistema está trabalhando por mim.
Com isso encerro o longo projeto [Re: Booting]. Do básico de Ciência da Computação até Linux, Docker e o pipeline de CI/CD. Espero que esse conhecimento, construído na raça e do zero, sirva de pequena luz para os ‘devs full stack pela sobrevivência’ que estão por aí, lutando sozinhos neste exato momento.