Mocniejsze niż jakakolwiek specyfikacja: „po prostu pokaż mi to na żywo”
Gdy zostałem jedynym programistą na placu boju projektu SI dla instytucji publicznej, największą barierą nie była technologia. Była nią 'niepewność’. Idealne środowisko, w którym projekt powstaje na podstawie precyzyjnej specyfikacji wymagań, po prostu nie istniało. Osoby odpowiedzialne za projekt, bez zaplecza technicznego, często same nie wiedziały, czego chcą, dopóki nie zobaczyły ekranu.
„Hmm, na rysunku jakoś nie do końca to widzę… nie da się tego po prostu kliknąć?”
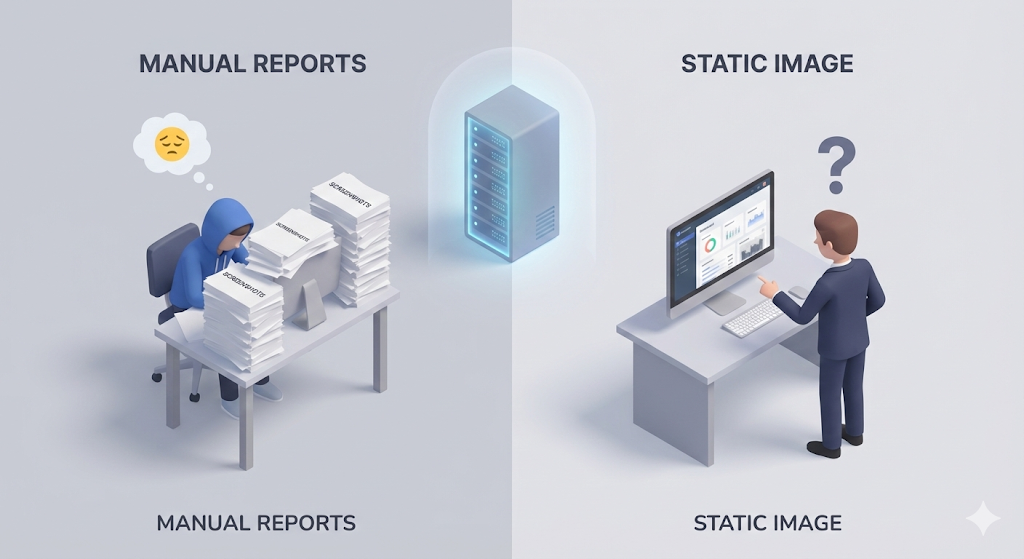
Za każdym razem, gdy kończyłem jakąś funkcję, uruchamiałem ją lokalnie (na swoim komputerze), robiłem zrzut ekranu, dodawałem komentarze czerwonym długopisem i wysyłałem mailem 'plik raportu (HWP/PPT)’. Tylko że samymi statycznymi obrazkami nie dało się zadowolić zamawiającego.
„A wiesz co, ta wcześniejsza wersja chyba była lepsza. Cofnij to.” „A co się dzieje po kliknięciu tego przycisku? Nagraj mi to na wideo.”
Wczoraj A, dzisiaj B. Edytuj kod lokalnie, znowu zrzut ekranu, znowu raport: nieskończona pętla. Sytuacja stanęła na głowie: pisanie raportów zajmowało więcej czasu niż samo programowanie.
W końcu boleśnie do mnie dotarło: 'nie chodzi o to, żebym wysyłał zrzuty ze swojego ekranu, tylko o to, żebym miał plac zabaw (serwer deweloperski), na który zamawiający może wejść, do woli klikać i próbować to zepsuć’.
Okazja przychodzi przypadkiem: ponowne odkrycie porzuconego serwera
Akurat w trakcie podziału firmy do naszego zespołu trafił z czystym fartem bezczynny serwer (pusty komputer). Specyfikacja nie była imponująca, ale miał zainstalowanego Linuksa i podpięte publiczne IP: cenny zasób.
„Szefie, mogę wziąć ten zbędny serwer? Chcę zbudować na nim serwer do walidacji dla zamawiającego.”
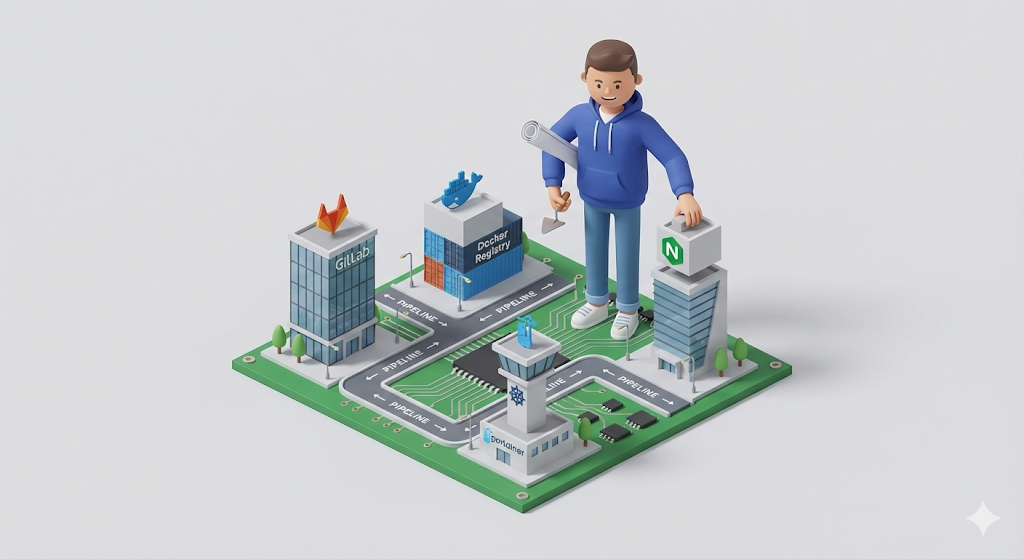
Zgoda padła. W tę pustą skorupę serwera wlałem wszystko, czego nauczyłem się dotychczas, i zacząłem budować 'moje małe imperium infrastruktury’. Było to podsumowanie kilku miesięcy walenia głową w mur (seria Works on My Machine & The Pipeline).
- GitLab (repozytorium kodu): stawiam prywatne repozytorium, żeby bezpiecznie zarządzać kodem.
- Docker Registry (repozytorium obrazów): tworzę nasz własny magazyn na zbudowane obrazy Dockera.
- Portainer (zarządzanie kontenerami): dzięki niemu ja, wciąż bojący się CLI, mogę zarządzać Dockerem przez GUI.
- Nginx (serwer WWW): stawiam odźwiernego, który kieruje ruchem żądań do frontendu i backendu.
Rozwiązanie: pełna separacja środowisk (Dev vs Prod)
Teraz miałem do dyspozycji dwie sceny (serwery). Aby uwzględniać kaprysy zamawiającego, jednocześnie chroniąc serwer produkcyjny, rozdzieliłem strategię wdrażania.
- Serwer deweloperski (Development): 'laboratorium swobodnych eksperymentów’
- Zamawiający nie zdąży nawet zapytać „czy to już gotowe?”.
- Gdy kod trafia na branch
develop, pipeline od razu rusza i następuje automatyczne wdrożenie. - Zamawiający w każdej chwili może wejść pod URL serwera deweloperskiego, przetestować funkcje i przekazać mi uwagi.
- Serwer produkcyjny (Production): 'sprawdzone sanktuarium’
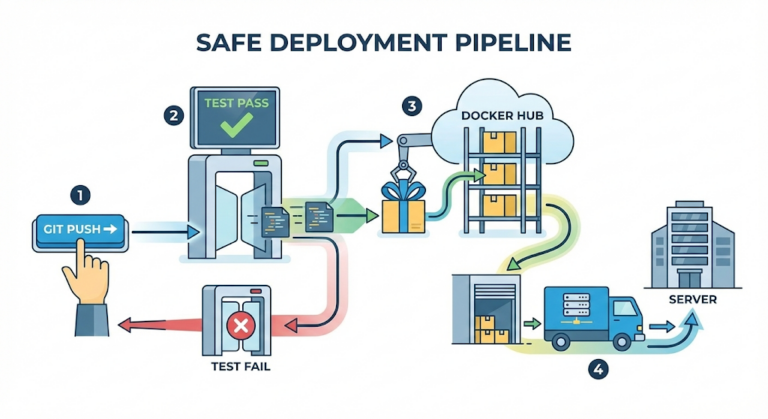
- Wdrożenie następuje tylko wtedy, gdy zamawiający ogłosi: „Ta funkcja to wersja ostateczna!”.
- Kod jest scalany (Merge) do brancha
master, a wdrożenie rusza dopiero, gdy sam kliknę w GitLabie 'przycisk zatwierdzenia wdrożenia’ (Manual).
[Code Verification] Wprowadzenie porządku przez warunkowe wdrażanie
GitLab CI pozwala wskazać różne ścieżki wdrażania dla poszczególnych gałęzi. Po przełożeniu tej strategii na kod wygląda to następująco.
stages:
  - build
  - deploy

# 1. Build (wspolny)
build_job:
  stage: build
  script:
    - ./gradlew build
    - docker build -t my-reg/app:$CI_COMMIT_SHA .
    - docker push my-reg/app:$CI_COMMIT_SHA

# 2. Wdrozenie na serwer deweloperski (automatyczne)
# Gdy kod trafia na branch 'develop', wdrazamy bez pytania.
deploy_to_dev:
  stage: deploy
  script:
    - ssh user@dev-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-dev"
  only:
    - develop

# 3. Wdrozenie na produkcje (recznie zatwierdzane)
# Nawet gdy kod trafia na branch 'master', wdrozenia nie ma, dopoki nie wcisne przycisku.
deploy_to_prod:
  stage: deploy
  script:
    - ssh user@prod-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-prod"
  only:
    - master
  when: manual # Kluczowe! Wykonuje sie tylko, gdy 'czlowiek wcisnie przycisk'.
Kluczowe punkty:
only: - develop: branch deweloperski jest zawsze wdrażany automatycznie. Tu liczy się przede wszystkim szybkość.when: manual: branch produkcyjny ma zabezpieczenie: człowiek jeszcze raz wszystko sprawdza i dopiero wtedy klika.
Na koniec: nareszcie pełnoprawne 'sam sobie radzę’
Teraz nawet dla mnie, programisty pracującego w pojedynkę, system jest kompletny.
- Lokalnie (Local): rozwijam funkcje na swoim komputerze.
- Serwer deweloperski (Dev): wystarczy jeden
git push, a po 5 minutach zmiany są już na serwerze deweloperskim. Zamawiający sprawdza je sam. - Serwer produkcyjny (Prod): zbieram tylko zatwierdzone funkcje i bezpiecznie wdrażam je jednym kliknięciem.
Tamtego mnie z początków pracy, zarywającego noce z włączonym narzędziem do zrzutów ekranu i komentarzami w plikach Hangul, już nie ma. Gdy zamawiający mówi „zmień to, proszę”, mogę odpowiedzieć „jasne, poprawiłem i wgrałem na serwer deweloperski, sprawdź”, a w międzyczasie spokojnie napić się kawy. Bo to system pracuje za mnie.
I tym samym kończę długi projekt [Re: Booting]. Od podstaw informatyki, przez Linuksa, Dockera, aż po pipeline CI/CD. Mam nadzieję, że ta wiedza, zbudowana od zera przez bicie głową w mur, stanie się małym światełkiem dla 'fullstack deweloperów z konieczności’, którzy teraz gdzieś tam samotnie walczą o swoje.