Maszyny nie znają angielskiego
Kiedy po raz pierwszy uczyłem się języka C w szkole, było coś, czego najbardziej nie rozumiałem. „Dlaczego mój kod nie działa od razu, ale czy musi przejść irytujący proces budowania i kompilacji?”.
Python uruchamia się natychmiast po napisaniu kodu i naciśnięciu klawisza Enter, ale Java i C wymagają czasochłonnych kroków. Kiedy byłem studentem, pomyślałem: „Każdy język ma inną gramatykę”. Kiedy przystępowałem do testu, wystarczyło odpowiedzieć „C to język kompilowany, a Python to język interpretowany”.
Jednak pracując z serwerami zaplecza, które w praktyce obsługują duże ilości ruchu, zdałem sobie sprawę, że ta prosta różnica stanowiła ogromną barierę determinującą wydajność i szybkość wdrażania systemu. Elegancki kod, który napisałem, był w rzeczywistości po prostu nieznanym, obcym językiem dla ignoranta i sumiennego pracownika zwanego CPU.

Co to jest, do cholery, „build”?
Czym dokładnie jest kompilacja? Czym to się różni od zwykłego „oszczędzania”?
Napisany przez nas kod źródłowy (.java, .c) to tak naprawdę plik tekstowy. Jest to „tekst”, który można odczytać nawet po otwarciu notatnikiem. Jednak komputery (procesory) nie potrafią czytać. Można jedynie wiedzieć, czy prąd płynie (1), czy nie (0).
Kompilacja to kompleksowy proces pakowania, który konwertuje zapisany przez nas „plik tekstowy” na „plik wykonywalny (.exe, .class, .jar), który może uruchomić komputer.
- Przetwarzanie wstępne (Preprocessing): usuwa komentarze i dołącza kod potrzebnych bibliotek.
- Kompilacja (Compilation): tłumaczy kod napisany po angielsku na język maszynowy (lub kod bajtowy).
- Linkowanie (Linking): łączy wiele przetłumaczonych plików w jeden, tworząc ostateczny plik wykonywalny.
Innymi słowy, jeśli kod źródłowy to „przepis na gotowanie (papier)”, kompilacja to proces przycinania i smażenia składników zgodnie z przepisem oraz serwowania „gotowego dania (jedzenia)”. Bez względu na to, jak bardzo zmodyfikujesz przepis (kod), jeśli nie ugotujesz go (zbudujesz) ponownie, zimne jedzenie, które zrobiłeś wczoraj, pozostanie na stole (serwerze).
Instrukcje pracy dla cyfrowego centrum dystrybucji
Aby zrozumieć ten złożony proces, porównaj wnętrze komputera z gigantycznym cyfrowym centrum logistycznym.
W tym przypadku CPU to procesor, który jest niewiarygodnie szybki, ale ma zerową elastyczność. Ten pracownik może czytać tylko instrukcje pracy zwane językiem maszynowym (0 i 1).
Pisanie kodu w języku Java lub Python to proces tworzenia „podręcznika pracy”, który można przekazać pracownikom. Problem w tym, że tę instrukcję piszemy po angielsku (języku programowania). Pracownik nie zna języka angielskiego. Dlatego potrzebujemy tłumaczy. Od tej metody tłumaczenia zależy los języka.
1. Kompilator: Profesjonalny tłumacz, który tłumaczy z wyprzedzeniem
- Typowe języki: C, C++, Java (hybrydowo), Go, Rust
- Sposób działania: przypomina przetłumaczenie całej książki naraz i wydanie jej z wyprzedzeniem. Zanim praca się zacznie, cały kod zostaje zamieniony na język maszynowy i powstaje plik wykonywalny (.exe, .class).
- Zalety: skoro wszystko zostało przetłumaczone wcześniej, pracownik (CPU) czyta instrukcje bardzo szybko. Wszystkie błędy składniowe są wyłapywane jeszcze przed uruchomieniem.
- Wady: nawet jeśli poprawisz w instrukcji tylko jedną linijkę, trzeba od nowa wydrukować całą książkę (Re-build).
2. Interpreter: Tłumacz symultaniczny w czasie rzeczywistym
- Typowe języki: Python, JavaScript, Ruby
- Sposób działania: stoi tuż obok pracownika przy pracy, czyta mu instrukcję zdanie po zdaniu i od razu ją tłumaczy.
- Zalety: poprawki w instrukcji działają od razu. Nie potrzeba osobnego pliku z tłumaczeniem.
- Wady: tłumaczenie zajmuje czas, więc praca idzie wolniej. Dopóki nie uruchomisz programu, nie wiesz, czy w dalszej części nie kryje się literówka.

[Weryfikacja kodu] Weryfikacja samego języka maszynowego
Naprawdę nie mogę tego poczuć, słysząc to. Sprawdźmy wizualnie, czy Python rzeczywiście tłumaczy wiersz po wierszu i jak wygląda kod widziany przez maszynę.
Python ma moduł o nazwie dis (Dezasembler). Dzięki temu możesz zobaczyć, które instrukcje są wewnętrznie podzielone na kod Pythona podczas jego wykonywania.
import dis

def my_function():
    a = 10
    b = 20
    print(a + b)

# Sprawdz, na jaki kod maszynowy (bytecode) jest konwertowany kod Pythona
print("--- Python Bytecode Verification ---")
dis.dis(my_function)
Po uruchomieniu tego kodu wyświetlane są następujące obce języki.
  5           0 LOAD_CONST               1 (10)
              2 STORE_FAST               0 (a)

  6           4 LOAD_CONST               2 (20)
              6 STORE_FAST               1 (b)

  7           8 LOAD_GLOBAL              0 (print)
             10 LOAD_FAST                0 (a)
             12 LOAD_FAST                1 (b)
             14 BINARY_ADD
             16 CALL_FUNCTION            1
             18 POP_TOP
             20 LOAD_CONST               0 (None)
             22 RETURN_VALUE
Analiza:
- Napisane przez nas
a = 10zostało rozbite na dwie instrukcje:LOAD_CONST(pobierz stałą 10) iSTORE_FAST(włóż ją do szybkiego schowka a). - Aby wykonać
print(a + b), uruchamiane sąBINARY_ADD(dodawanie binarne) iCALL_FUNCTION(wywołanie funkcji). - Interpreter Pythona w czasie działania programu odczytuje te instrukcje jedna po drugiej i uruchamia wewnętrzną logikę napisaną w języku C. Innymi słowy, nie wydaje poleceń bezpośrednio CPU, lecz „maszynie wirtualnej (VM)”, która rozmawia z CPU. To właśnie dlatego Python jest wolniejszy od C.
Z drugiej strony, po skompilowaniu język C jest bezpośrednio tłumaczony na rzeczywisty język asemblera procesora, taki jak MOV EAX, 10 (umieść 10 w rejestrze EAX). Ponieważ nie ma menedżerów średniego szczebla, nie ma innego wyjścia, jak tylko działać szybko.
Kompromis w praktyce: który wybrać?
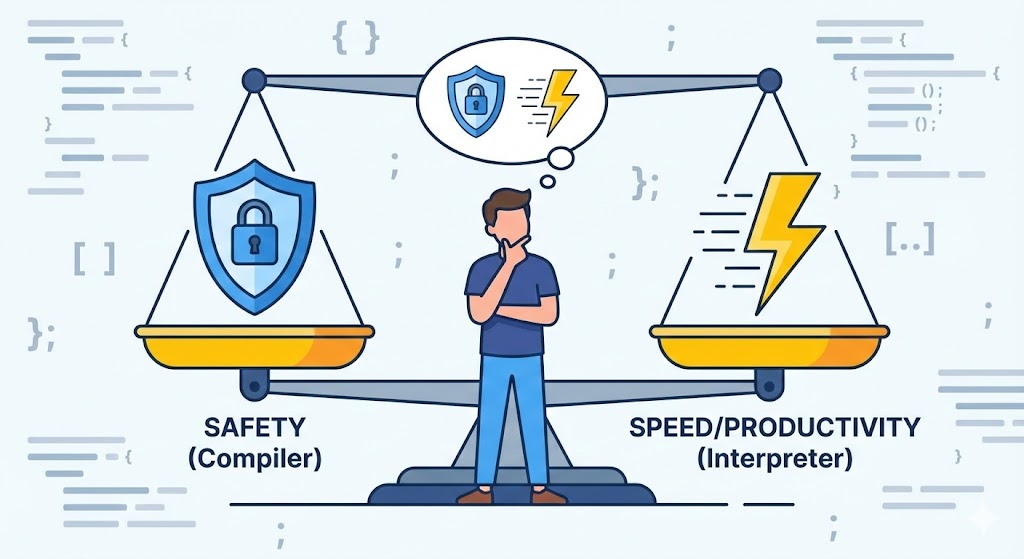
Kiedy byłam studentką, najważniejsza była wygoda. Zamiast języka C, w którym występują błędy kompilacji, wolałem Pythona lub JavaScript, który można łatwo napisać i uruchomić. Jednak w praktyce należy dokonać ostrego kompromisu między stabilnością a produktywnością.
1. Strach przed błędami wykonania (słabość interpretera)Najbardziej przerażającą rzeczą podczas budowania serwera w Pythonie jest to, że serwer zatrzymuje się o 3 w nocy z powodu pojedynczej literówki. Interpreter nie wie o błędzie, dopóki nie zostanie uruchomiony (punkt, w którym wykonywany jest kod). Z drugiej strony Java (język skompilowany) pyta: „Popełniłem literówkę?” podczas tworzenia kodu. I on mi mówi. Ta rygor w wychwytywaniu błędów przed wdrożeniem staje się wybawieniem w projektach na dużą skalę.
2. Nudny czas kompilacji (słabość kompilatora) Z drugiej strony, gdy projekt Java się rozrasta, modyfikacja i sprawdzenie pojedynczej linii kodu może zająć kilka minut (Gradle Build…). Właśnie dlatego Python jest w przeważającej mierze używany na wczesnych etapach startupów, gdzie krytyczne są szybkie modyfikacje i wdrożenia, lub w zadaniach wymagających natychmiastowych wyników, takich jak analiza danych.
Wniosek: teoria staje się bronią
Teraz wiemy, że proces „kompilacji i kompilacji” oraz sposób tłumaczenia kodu różnią się w zależności od języka. Teoretycznie właściwym rozwiązaniem byłby wybór najlepszego języka w zależności od charakteru projektu.
Ale rzeczywistość nie była taka łaskawa. Firma, do której dołączyłem, miała już ustalony stos technologii i chociaż dołączyłem jako programista Java, musiałem dotknąć Pythona, JavaScript, a nawet XML Androida.
Paradoksalnie, tym, co uratowało mnie z tej zagmatwanej dziedziny „wszystkożernego rozwoju”, były „podstawowe teorie”, których się dzisiaj nauczyłem. Dzieje się tak dlatego, że chociaż powłoka języka jest inna, zasady w nim działające są takie same.
Następnym razem opowiem o moich praktycznych doświadczeniach o tym, jak „zagłębiłem się w jeden język (Java), aby kierować reklamy na inne języki” i dlaczego podstawy są ważne, aby uniknąć stania się niewolnikiem frameworku.