即使公司原地解体的那一天,修 Bug 的请求也照样会来
入职第 6 个月,因为公司的情况,组织在那一天原地解体,只剩下我们团队孤零零地独立出来。办公室一片混乱,组长对我说:“技术这块我现在也不太懂了,都得你来做。” 然后把基础设施管理的全部权限都交给了我。
即便是在这样的混乱之中,电话铃声还是响了起来。是客户打来的:“那个,登录页面报错了,麻烦尽快修一下。”
我的脑子一下空白了。以前的话,只要我在本地修好,再 git push 一下,放在别的部门服务器上的 Jenkins 或 GitLab 就会自动把它部署到生产服务器上。但现在,那条链路已经断掉了。
现在已经没有能帮我的“部署机器人”了。只能靠我自己把这份代码一步步搬到生产服务器上。那一刻真的很茫然。但也就在那时,过去几个月里我一次次硬着头皮撞出来的那些知识,从脑海中一闪而过。
“等等,先冷静。只要理解原理,手动也能做。先一步一步,安全地把它搬过去。”
Git 与 GitLab:代码的仓库
首先,我得先把断掉的桥重新搭起来。最先需要的就是“Git”和“GitLab”。
- Git:帮我保存代码、管理版本(历史)的工具。(时光机)
- GitLab:不仅有 Git 仓库的功能,还是一个连部署自动化 (CI/CD) 工具也整合在一起的平台。
“一般不是都更常用 GitHub 吗?” 没错。更大众的选择通常是 GitHub,包括 GitHub Actions,而传统强者 Jenkins 也常常被单独搭建出来使用。
但我们当时处在一个外部访问受限的封闭内网环境里,所以能够直接安装在自家服务器上的 GitLab Self-Hosted 才是最合适的选择。工具可以不同,但本质都一样:把代码存起来,然后自动部署出去。
我熬夜在服务器上装好了 GitLab,又把代码迁了过去。
“呼,这下再 push 一次应该就能部署了吧?”
我怀着期待修改了代码,然后敲下 git push origin master。代码顺利进了 GitLab 仓库,但生产服务器却纹丝不动。无论等多久,功能都没有更新。
手动部署的血泪史:找回丢失的流程
“咦?为什么没有部署?” 没有前辈可问,也没有可以依靠的组长。我只能自己去找答案。
仔细一想,这事其实很奇怪。GitLab 不过就是一个“存放代码的图书馆”。图书馆里进了新书,不代表它会自动摆到书店,也就是生产服务器,的货架上。以前一定是中间有什么东西帮我完成了这次“配送”。
“那难道要我自己亲自送过去?”
于是我开始一步一步摸索手动部署的过程。结果发现这件事比想象中复杂得多,也麻烦得多。
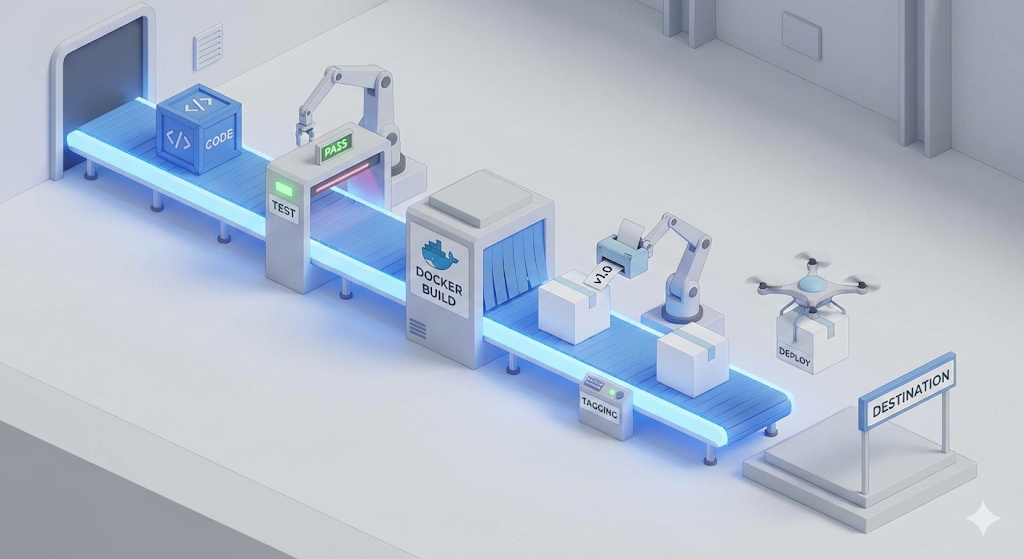
第 1 步:测试与构建 (Test & Build) – 把次品筛出去
最先要做的,是确认我电脑里的 Java 代码本身没有问题,并把它变成可运行的状态。不能只是简单复制文件。我得先确认自己改过的代码有没有把原来的逻辑弄坏,测试,以及有没有语法错误,构建。
我打开终端,敲下命令:./gradlew test clean build
伴随着绿色的勾号,屏幕上出现了“所有测试通过”的提示。还好。要是这里报错了呢? 那就是“次品”。这种代码绝对不能上服务器。这个过程,就是检查代码是否具备最基本资格的“第一道安全装置”。
第 2 步:生成镜像 (Dockerize) – 把环境整个封存起来
接下来,我得把这个 jar 文件送到服务器上。只是把文件传过去就行吗? 不行。“Works on My Machine” 这个系列已经让我深刻认识到,我的电脑,Java 17,和服务器,Java 8,的环境可能完全不同。所以我们决定“把环境整个冻住”一起发过去。也就是“Docker”。
我在项目根目录创建了一个 Dockerfile,然后熟练地写了出来。
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
接着把镜像烤了出来。docker build -t my-app:v1 .
现在,我的代码已经变成了一个无论扔到哪台服务器上都能一样运行的“不朽容器镜像”。Docker 就是防止环境差异导致错误的“第二道安全装置”。
第 3 步:运输 (Push & Pull) – 利用公共仓库
镜像准备好了。接下来要把它搬到生产服务器上。幸运的是,“Docker Hub” 不是公司的内网服务器,而是互联网上的外部服务,也就是 SaaS。公司解体之后,内网里的 GitLab 链路断了,但通往外网的路还在。
我用发抖的手,把镜像推送到了公共物流仓库 Docker Hub 上。
- 从我的电脑上传:
docker push my-id/my-app:v1
过了一会儿,屏幕上出现上传完成的提示。现在该去另一端,也就是生产服务器了。不是跑去机房,而是通过“SSH (Secure Shell)”进行安全的远程连接。
ssh user@production-server
在连接成功后的黑色界面,也就是 CLI 里,把刚才上传好的镜像拉下来。docker pull my-id/my-app:v1
第 4 步:部署 (Run) – 替换上线
终于到了最后一步。服务器上已经跑着旧版本服务了。我要把它停掉,再把新版本拉起来。Linux 命令从指尖一条条敲了出去。
- 停止并删除旧容器:
docker stop my-app && docker rm my-app - 运行新容器:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
按下回车的瞬间,屏幕上打印出一长串哈希值,再用 docker logs -f my-app 查看日志时,熟悉的 Spring 标志终于出现了。客户又打来了电话:“咦? 现在好了,谢谢!”
但“人”终究还是会犯错
第一次手动部署是成功的。我信心满满:“什么嘛,一个人也能搞定啊?” 但这种自满并没有持续太久。在不断重复的手工操作里,人的极限很快就暴露出来了。
危机 1. 狭路相逢的 Bug (缺少 Git Branch)
几天后,我正在按客户 A 的要求修改“登录功能”,客户 B 却突然联系我,说“支付功能”爆出了致命 Bug,必须立刻修复。
我一下慌了。虽然我在用 Git,但因为一直拿“反正就我一个人开发”当借口,所有工作都堆在同一个 master 分支上。为了改登录功能,代码早已经乱成一团了。
“等等? 我现在如果只修支付 Bug 然后直接部署,那未完成的登录代码不是也会一起上去吗?”
最后,我只能用最原始的办法,把正在改的代码先备份成临时文件,再用 git reset 把代码回退。结果在这个过程中,我甚至还因为操作失误把一部分代码弄丢了。
危机 2. 我没有同事 (缺少 Test Code)
经历一番折腾之后,我终于修好支付 Bug 并部署了。正准备松一口气时,又有人反馈“注册功能不能用了”。后来才发现,是我在修改支付逻辑时动到了一个公共的用户校验函数。
“啊… 要是当时有人帮我看一下代码,做个 Code Review,就不会犯这种错了。”
可我既没有能帮我看代码的前辈,也没有同事。我是一个人。实际上,注册功能当时做得太仓促,连 Unit Test 都没来得及写。如果那时再麻烦也把测试代码补上,那么当我改支付逻辑把注册功能搞坏时,机器就会立刻亮起红灯。
危机 3. “服务器挂了!” (缺少 Docker Tag)
又过了几天,真正的致命一击来了。我急急忙忙加了个功能就部署,结果服务器刚启动就因为业务逻辑错误直接崩了。罪魁祸首正是跳过了测试。
客户的电话一下子打爆了过来:“请马上回滚到之前的版本!” 我颤抖着打开服务器终端,却发现根本没有回滚的办法。
因为我每次都嫌麻烦,一直只是把镜像名覆盖成 my-app:latest。既没有单独打上 v1、v2 这样的版本标签,上一版正常可用的镜像也早就不见了。最后,我只能先放着已经停掉的服务器,回到本地重新修代码,再从头构建。创建镜像、传到生产服务器、重新启动容器,总共花了 10 分钟。而我还得写一份服务器停机事故经过说明书上交。
结语:这一整套流程,原来就叫“流水线”
在那 10 分钟如同地狱一般的宕机之后,我一边写着事故说明书,一边回顾自己这几天所经历的一切。
- Git Branch:安全隔离并管理代码的起点。
- Test & Code Review:拦住次品、不让它流入下一阶段的过滤网。
- Build & Dockerize:把代码打包成可运行环境的过程。
- Docker Tag & Push:为应对万一,记录并保存版本的过程。
- Deploy:在服务器上运行安全镜像的最后一步。
过去,我对这些流程的理解一直都是零散的知识片段。有时候因为嫌麻烦就省略了,有时候因为根本不懂就跳过去了。但实战中发生的事故证明了,这些步骤里任何一步都不能少,它们全都是“必不可少的安全装置”。
然后我终于明白了,自己一直苦苦寻找的“自动化”到底是什么。它并不只是一个替我敲命令的机器,而是一条能让第 1 到第 5 步 像流水一样不断流、而且不掺杂人为失误 地自动完成的路径。
那正是 CI/CD Pipeline。
“组长,我现在明白了。我们真正需要的,是让这些安全装置自动运转起来的‘流水线’。”
下一篇,我们就以这张设计图为基础,真正搭建属于自己的部署机器人,也就是 CI/CD Pipeline。