Incluso el día en que la empresa se desintegró, siguieron llegando solicitudes de corrección de bugs
Seis meses después de entrar a la empresa, el día en que la organización se vino abajo por la situación de la compañía y solo nuestro equipo quedó aislado e independiente, la oficina era un caos. Mi jefe de equipo me dijo: “Ya no entiendo bien la parte técnica, así que tú tendrás que encargarte de todo”, y me entregó la autoridad total sobre la gestión de la infraestructura.
Incluso en medio de aquella confusión, el teléfono no dejaba de sonar. Era un cliente. “Oiga, hay un error en la página de inicio de sesión. Arréglelo cuanto antes, por favor.”
Me quedé en blanco. Antes, si lo corregía en local y hacía un simple git push, Jenkins o GitLab en el servidor de otro departamento lo desplegarían automáticamente al servidor de producción. Pero ese enlace ya se había roto.
Ahora ya no había ningún “robot de despliegue” que me ayudara. Tenía que llevar este código al servidor de producción con mis propias manos. Era abrumador. Pero en ese momento, los conocimientos que había ido aprendiendo a base de golpes durante los últimos meses cruzaron mi mente.
“Espera, cálmate. Si entiendo el principio, también puedo hacerlo manualmente. Vamos a moverlo con seguridad, paso a paso.”
Git y GitLab: el almacén del código
Lo primero era reconstruir el puente que se había roto. Lo que necesitaba antes que nada era “Git” y “GitLab”.
- Git: es la herramienta que guarda mi código y gestiona sus versiones (su historia). (Una máquina del tiempo)
- GitLab: es una plataforma que, además de la función de repositorio Git, integra en un solo lugar las herramientas de automatización del despliegue (CI/CD).
“¿No se suele usar más GitHub?” Sí, es cierto. De forma general, lo más usado es GitHub, con GitHub Actions, y también hay equipos que montan por separado al clásico peso pesado, Jenkins.
Pero nosotros trabajábamos en un entorno de red interna cerrado, con acceso externo restringido, así que GitLab Self-Hosted, que podíamos instalar directamente en nuestro propio servidor, era la mejor opción. Las herramientas pueden variar, pero la esencia es la misma: almacenar el código y desplegarlo automáticamente.
Pasé la noche instalando GitLab en el servidor y trasladando el código.
“Uf, ahora si vuelvo a hacer push, debería desplegarse, ¿no?”
Con ilusión, modifiqué el código y lancé git push origin master. El código subió bien al repositorio de GitLab. Pero el servidor de producción no se movió en absoluto. Por mucho que esperé, la funcionalidad no se actualizó.
El sufrimiento del despliegue manual: buscar el proceso perdido
“¿Eh? ¿Por qué no se despliega?” No tenía ningún senior al que preguntar ni ningún jefe de equipo en quien apoyarme. Tenía que encontrar la respuesta por mi cuenta.
Cuanto más lo pensaba, más raro me parecía. GitLab no es más que una “biblioteca que guarda código”. El hecho de que llegue un libro nuevo a la biblioteca no significa que aparezca automáticamente en la estantería de la librería, es decir, del servidor de producción. Antes, había algo en medio que se encargaba de ese reparto.
“Entonces, ¿me toca repartirlo a mí mismo?”
Empecé a recorrer el proceso de despliegue manual paso a paso. Era muchísimo más complejo y tedioso de lo que esperaba.
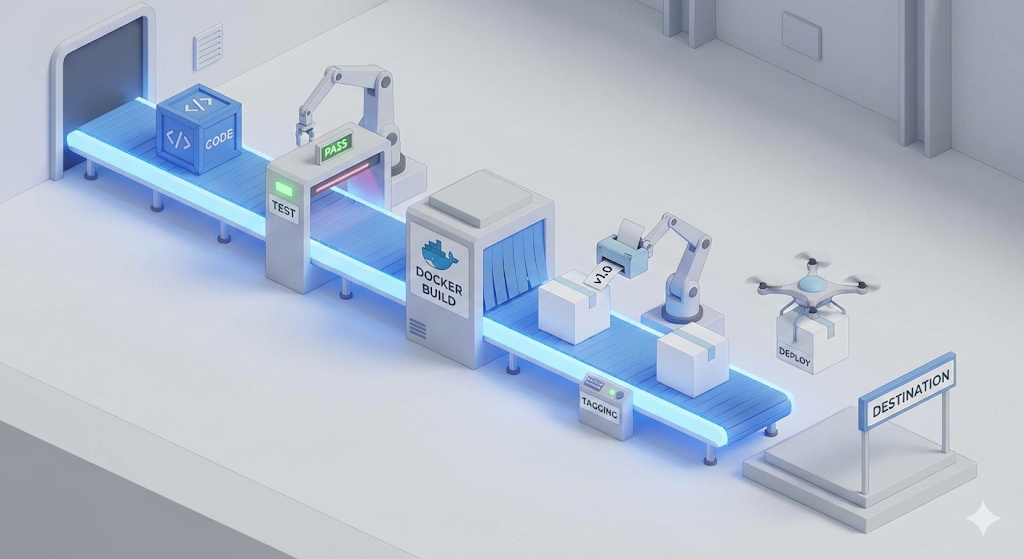
Paso 1: pruebas y compilación (Test & Build) – filtrar productos defectuosos
Lo primero que tenía que hacer era verificar que el código Java de mi equipo estuviera bien y convertirlo en algo ejecutable. No bastaba con copiar archivos. Tenía que confirmar si el código que había modificado había roto la lógica existente, test, y si había errores de sintaxis, build.
Abrí la terminal y escribí el comando: ./gradlew test clean build
Apareció un mensaje con marcas verdes diciendo que todas las pruebas habían pasado. Menos mal. ¿Y si aquí hubiera saltado un error? Entonces habría sido un “producto defectuoso”. Ese código no debía subir al servidor. Este proceso era la “primera medida de seguridad”, la que comprueba si el código cumple los requisitos mínimos.
Paso 2: creación de imagen (Dockerize) – congelar el entorno
Ahora tenía que enviar ese archivo jar al servidor. ¿Bastaba con mandar solo el archivo? No. La serie “Works on My Machine” me había enseñado a las malas que el entorno de mi ordenador, Java 17, y el del servidor, Java 8, podían ser distintos. Por eso decidimos “congelar todo el entorno” y enviarlo junto. Para eso estaba Docker.
Creé un Dockerfile en la raíz del proyecto y lo escribí con soltura.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Después horneé la imagen. docker build -t my-app:v1 .
Ahora mi código se había convertido en una “imagen de contenedor” inmortal, capaz de funcionar igual en cualquier servidor donde la lanzara. Docker era la “segunda medida de seguridad”, la que evitaba errores por diferencias de entorno.
Paso 3: transporte (Push & Pull) – usar un almacén común
La imagen estaba lista. Ahora había que moverla al servidor de producción. Por suerte, “Docker Hub” no era un servidor interno, sino un servicio externo en internet, es decir, SaaS. Cuando la empresa se desintegró, se cortó la conexión con GitLab dentro de la red interna, pero el camino hacia la red externa seguía abierto.
Con manos temblorosas, envié la imagen a Docker Hub, el almacén logístico compartido.
- Subida desde mi ordenador:
docker push my-id/my-app:v1
Poco después apareció el mensaje de que la subida había terminado. Ahora tocaba conectarse al otro lado, al servidor de producción. No corriendo a la sala de servidores, sino mediante una conexión remota segura por “SSH (Secure Shell)”.
ssh user@production-server
Desde la pantalla negra conectada, la CLI, descargué la imagen que acababa de subir. docker pull my-id/my-app:v1
Paso 4: despliegue (Run) – reemplazar
Por fin, el último paso. En el servidor ya estaba corriendo la versión antigua. Había que apagarla y levantar la nueva. Los comandos de Linux empezaron a salir solos de mis dedos.
- Detener y eliminar el contenedor existente:
docker stop my-app && docker rm my-app - Ejecutar el nuevo contenedor:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
En cuanto pulsé Enter, apareció un hash larguísimo y, al revisar los logs con docker logs -f my-app, surgió el familiar logo de Spring. Entonces el cliente volvió a llamar. “¿Eh? Ahora sí funciona bien. ¡Gracias!”
Pero al final las personas se equivocan
Aquel primer despliegue manual fue un éxito. Me llené de confianza. “¿Qué es esto? Si incluso solo puedo hacerlo.” Pero esa arrogancia no duró mucho. En medio de tareas manuales repetidas, los límites humanos aparecieron enseguida.
Crisis 1. Un bug en un puente de un solo tablón (la ausencia de ramas de Git)
Unos días después, estaba corrigiendo la “función de inicio de sesión” para el cliente A cuando, de repente, el cliente B me avisó de que había estallado un bug crítico en la “función de pagos” y que debía arreglarlo de inmediato.
Entré en pánico. Sí usaba Git, pero como excusa por desarrollar solo, hacía todo el trabajo en una única rama master. El código ya estaba hecho un caos, mezclado con los cambios de la función de inicio de sesión.
“¿Eh? Si arreglo solo el bug de pagos y despliego en este estado, ¿también subirá el código incompleto del login?”
Al final tuve que recurrir a un método primitivo: guardar en archivos temporales el código en el que estaba trabajando y revertirlo con git reset. En ese proceso incluso llegué a perder parte del código por error.
Crisis 2. No tengo compañeros (la ausencia de código de prueba)
Tras muchos giros, corregí el bug de pagos y lo desplegué. Justo cuando iba a respirar, llegó otro aviso: ahora el “registro” no funcionaba. Resultó que, al modificar la lógica de pagos, había tocado una función compartida de validación de usuarios.
“Ah… si alguien hubiera revisado mi código, un Code Review, no habría cometido este error.”
Pero no tenía ningún senior que revisara mi código ni tampoco compañeros. Estaba solo. De hecho, como hice la función de registro con demasiada prisa, ni siquiera llegué a escribir pruebas unitarias. Si en aquel momento, por molesto que fuera, hubiera preparado código de prueba, la máquina habría encendido una luz roja en cuanto rompí el registro al tocar la lógica de pagos.
Crisis 3. “¡El servidor se cayó!” (la ausencia de Docker tags)
Y unos días después llegó el golpe definitivo. Añadí una función con prisas y la desplegué, pero el servidor se cayó por un error de lógica de negocio justo al arrancar. La causa había sido omitir las pruebas.
El cliente comenzó a llamarme sin parar. “¡Por favor, hagan rollback a la versión anterior cuanto antes!” Abrí la terminal del servidor con las manos temblando. Pero no tenía forma de revertir.
Como me daba pereza hacerlo bien, siempre sobrescribía la imagen usando solo my-app:latest. Como no añadía etiquetas de versión separadas como v1 o v2, la imagen estable de la versión anterior ya había desaparecido. Al final no me quedó otra que dejar atrás el servidor caído, volver al entorno local, corregir el código otra vez y reconstruirlo todo desde cero. Entre crear la imagen, moverla al servidor de producción y reiniciar el contenedor pasaron 10 minutos, y además tuve que redactar un informe explicando cómo se había producido la caída del servidor.
Para cerrar: el nombre de todo este proceso era “pipeline”
Mientras escribía aquel informe a cambio de 10 minutos de infierno en forma de downtime, repasé todo lo que había vivido en los últimos días.
- Git Branch: el punto de partida para aislar y gestionar el código de forma segura.
- Test & Code Review: el filtro que impide que los productos defectuosos pasen a la siguiente etapa.
- Build & Dockerize: el proceso de empaquetar el código en un entorno ejecutable.
- Docker Tag & Push: el proceso de registrar y guardar las versiones por si ocurre lo peor.
- Deploy: la última etapa, en la que se ejecuta en el servidor una imagen segura.
Hasta entonces, solo había entendido estos procesos como fragmentos de conocimiento dispersos. A veces los omitía por pereza. Otras veces, porque no sabía mejor. Pero los incidentes que sufrí en la práctica demostraron que cada uno de esos pasos era un mecanismo de seguridad esencial que no podía faltar.
Y entonces me di cuenta de qué era realmente esa “automatización” que tanto había estado buscando. No era simplemente una máquina que escribía comandos por mí. Era el camino que hace que los pasos del 1 al 5 fluyan como el agua, sin interrupciones y sin errores humanos.
Eso era exactamente el pipeline de CI/CD.
“Jefe, ahora ya lo entiendo. Lo que necesitamos es un ‘pipeline’ en el que estos mecanismos de seguridad funcionen automáticamente.”
La próxima vez, partiendo de este plano, construyamos de verdad mi propio robot de despliegue: el pipeline de CI/CD.