Conocimiento para entrevistas, como la presentación personal de un minuto
«¿Cuál es la diferencia entre un proceso y un hilo?»
Cuando me preparaba para conseguir mi primer trabajo, esta pregunta aparecía siempre en el «TOP 10 de preguntas habituales en entrevistas». Yo respondía como una máquina:
«Un proceso es un programa en ejecución, y un hilo es una unidad de flujo que se ejecuta dentro de un proceso. Los procesos no comparten recursos, pero los hilos sí».
El entrevistador asentía, y yo me convencí, equivocadamente, de que entendía el concepto a la perfección. Pero hasta que me topé con los «problemas de concurrencia» (concurrency issues) en el trabajo real, no tenía ni idea de lo verdaderamente aterrador que escondía esa frase.
«¿Por qué el contador de visitas debería subir 100 y solo sube 98?». «¿Por qué se congela la web cuando alguien lanza una descarga de Excel?».
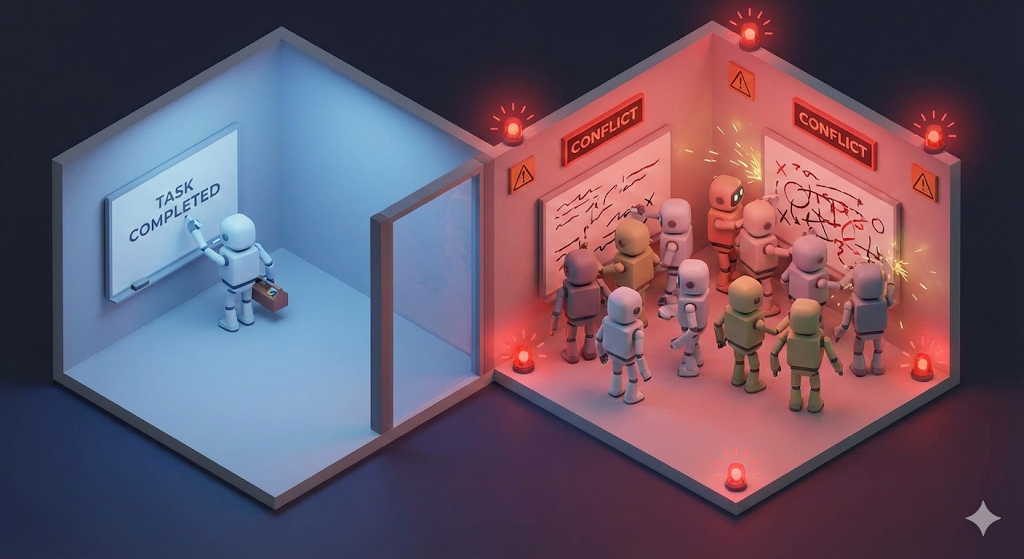
Mi código era perfecto cuando lo ejecutaba yo solo, pero en cuanto entraron varios usuarios a la vez, se volvió un desastre. Yo creía que bastaría con sumar más «trabajadores», pero no sabía que, cuantos más trabajadores hay, más crece, de forma exponencial, el costo de gestionarlos (context switching).
Fábricas y trabajadores del centro logístico digital
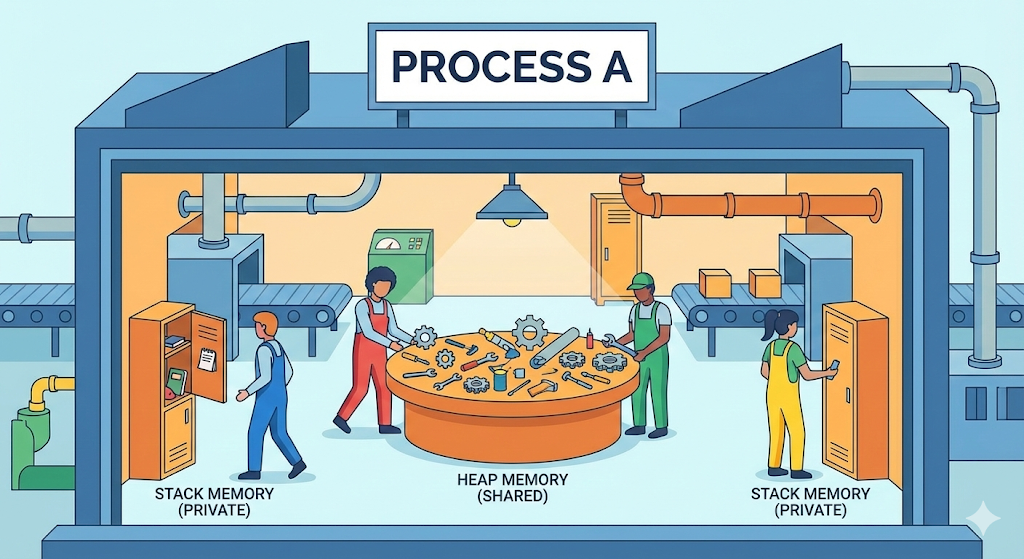
Volvamos al universo de nuestro «centro logístico digital». Que un programa se ejecute dentro de una computadora es como montar un «taller» (factory) dentro del centro logístico.
1. Proceso (Process): un taller independiente
- Definición: una «unidad de trabajo independiente» a la que el sistema operativo (el jefe de planta) le asigna recursos.
- Característica: cada uno tiene su propio edificio. Aunque la fábrica de al lado se derrumbe (un error), la mía sigue a salvo.
- Costo: para levantar una fábrica necesitas terreno (memoria) y también dar de alta la empresa (PID). «Caro y pesado».
- Uso compartido: en principio, no puedes llevarte cosas de la fábrica de al lado. (Hay que usar una comunicación complicada llamada IPC).
2. Hilo (Thread): los operarios dentro del taller
- Definición: el «trabajador» que hace el trabajo de verdad dentro del proceso (el taller).
- Característica: una sola fábrica puede tener varios operarios (multihilo).
- Costo: contratar a un operario nuevo es mucho más «barato y ligero» que construir una fábrica nueva.
- Uso compartido: esta es la clave. Los operarios comparten «el comedor (Heap) y la sala de descanso (Data)».
[Code Verification] La tragedia de lo compartido (problemas de concurrencia)
«Los hilos comparten recursos». En la entrevista, esta frase sonaba a ventaja, pero en el trabajo real puede ser la semilla de un «desastre».
¿Recuerdas el «heap» que vimos la última vez? Los hilos comparten esta zona del heap. Es decir, el hilo B puede llegar y sobrescribir los datos con los que está trabajando el hilo A.
Esto se llama «condición de carrera» (race condition). Comprobémoslo con código.
public class RaceConditionTest {
    static int count = 0; // Variable compartida que se guarda en el heap

    public static void main(String[] args) throws InterruptedException {
        // Contratamos a dos trabajadores (hilos)
        Thread t1 = new Thread(() -> {
            for (int i = 0; i < 10000; i++) count++;
        });

        Thread t2 = new Thread(() -> {
            for (int i = 0; i < 10000; i++) count++;
        });

        t1.start(); // ¡A trabajar!
        t2.start(); // ¡A trabajar!

        t1.join(); // Esperar a que termine su jornada
        t2.join(); // Esperar a que termine su jornada

        System.out.println("Resultado final: " + count);
    }
}
Resultado esperado: como dos trabajadores suman 10.000 veces cada uno, debería salir 20,000.
Resultado real: 15,482, 18,931… El valor cambia cada vez que lo ejecutas y no llega a 20.000.
Por qué:
- El hilo A lee
count(100)del heap y lo lleva a su stack. - Mientras tanto, el hilo B también lee
count(100)del heap. - El hilo A lo sube a 101 y lo guarda en el heap.
- El hilo B (como lo que leyó era 100) también lo sube a 101 y lo guarda en el heap.
- Se sumó dos veces, pero el resultado es como si se hubiera sumado una sola.
Este es el verdadero origen del bug de «a veces se pierden datos» que aparece en el trabajo real. Es la tragedia que ocurre cuando los trabajadores tocan el mismo libro de cuentas sin hablar entre ellos.
Si lo comparamos con una base de datos (BD), es exactamente lo mismo que «lanzar varias consultas a la vez sin una transacción». Como el saldo de una cuenta se modifica al mismo tiempo sin ningún mecanismo de protección (lock), estalla un accidente terrible: el dinero se evapora. Igual que en la base de datos protegemos los datos con ROLLBACK o COMMIT, a nivel de código también necesitamos sí o sí un mecanismo de bloqueo como Synchronized.
El trade-off en la práctica: multiproceso vs. multihilo
Entonces, en el trabajo real, ¿qué conviene usar y cuándo?
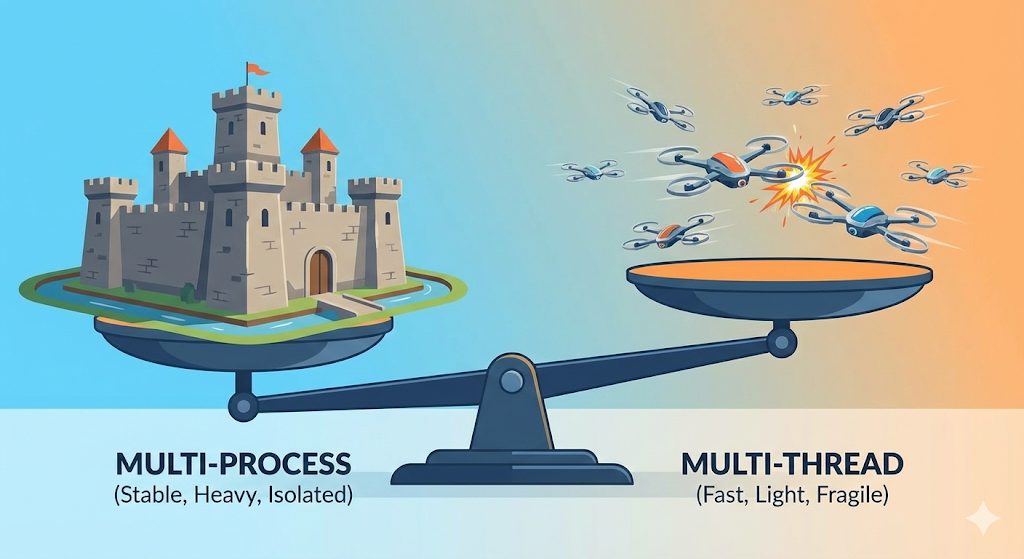
1. La elección del navegador Chrome: multiproceso
En el viejo Internet Explorer, si se colgaba una pestaña, se cerraba todo el navegador (enfoque multihilo). En cambio, Chrome abre cada pestaña como un «proceso independiente» (una fábrica aparte).
- Ventaja: aunque una pestaña deje de responder (aunque la fábrica explote), las demás pestañas (las fábricas vecinas) siguen intactas. (Estabilidad)
- Desventaja: consume una cantidad enorme de memoria. Por eso Chrome se ganó la fama de «devorador de RAM». (Costo)
2. La elección de los servidores web (Spring, Node.js, etc.): multihilo
Un servidor tiene que atender las peticiones de miles de personas. Si construyera un proceso (una fábrica) por cada petición, el servidor reventaría. Por eso coloca muchísimos hilos (operarios) dentro de un solo proceso para atenderlas.
- Ventaja: usa pocos recursos y es rápido. (Eficiencia)
- Desventaja: si un solo hilo provoca un error que tumba el proceso, se cae todo el servidor. Además, el propio desarrollador tiene que evitar los problemas de concurrencia que vimos antes (Synchronized).
Para terminar: la técnica de los clones de sombra conlleva responsabilidad
Hoy hemos visto «procesos e hilos», la forma en que trabajan nuestros operarios.
- Proceso: un taller independiente, seguro pero caro.
- Hilo: un compañero de trabajo ligero y rápido, pero con riesgo de conflictos.
Ahora ya sabes que «problemas de concurrencia» no es solo una expresión para entrevistas. Por ese almacén compartido llamado heap entran y salen sin parar innumerables hilos operarios. Poner orden en medio de ese caos es lo que demuestra el nivel de un desarrollador backend.
Pero un momento: cuando hay muchos operarios, ¿cómo se decide quién hace primero el trabajo de quién? ¿Cómo gestiona el jefe de planta (el SO) a cientos de operarios? La próxima vez hablaremos de la tarea que más dolores de cabeza le da al jefe de planta: «la planificación (scheduling) y el cambio de contexto (context switching)».