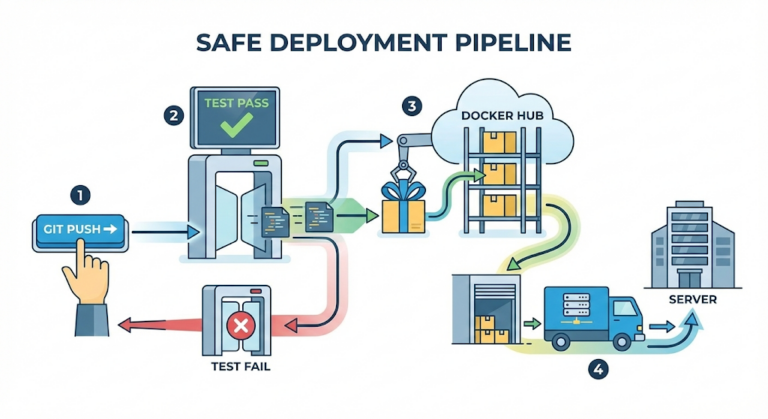
Una frase más poderosa que cualquier documento de planificación: «Primero muéstremelo, a ver»
Cuando me tocó encargarme yo solo de todo el desarrollo en un proyecto de integración de sistemas (desarrollo por encargo) para un organismo público, el mayor obstáculo no fue la tecnología. Fue la «incertidumbre». No existía ese entorno ideal en el que se diseña a partir de una especificación de requisitos minuciosa. Los responsables del cliente, con pocos conocimientos de desarrollo, muchas veces ni siquiera sabían lo que querían hasta ver la pantalla con sus propios ojos.
«Mmm, viéndolo en una imagen no me hago una idea… ¿No puedo pulsarlo de verdad?»
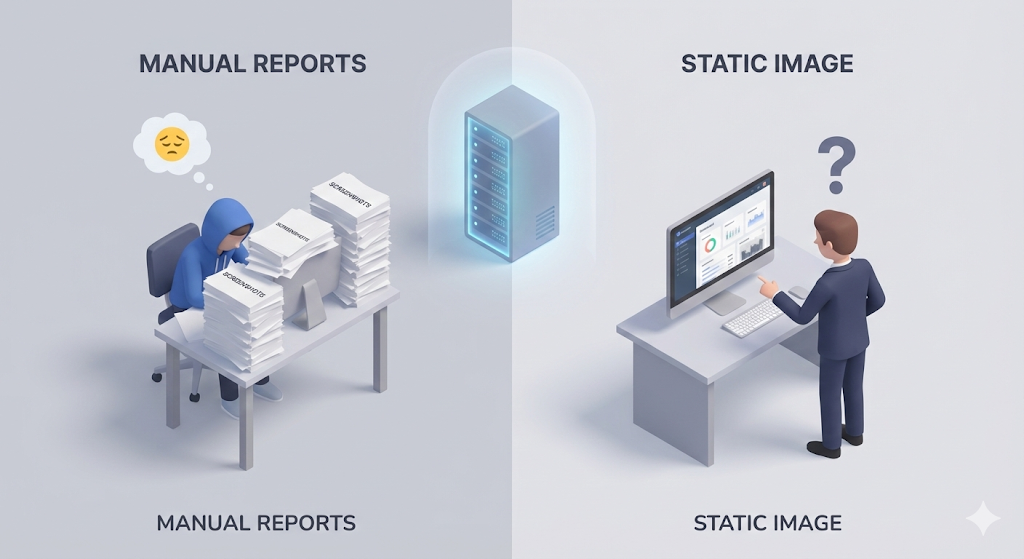
Cada vez que terminaba una funcionalidad, la ejecutaba en local (en mi propia máquina), hacía capturas de pantalla y preparaba un «archivo de informe» (HWP/PPT; HWP es el formato de procesador de textos habitual en Corea) con anotaciones en bolígrafo rojo, que enviaba por correo. Pero con simples imágenes estáticas no conseguía dejar satisfecho al responsable.
«Ah, creo que la funcionalidad de antes era mejor. Vuelva a dejarla como estaba». «¿Qué pasa si pulso este botón? Grábelo en vídeo».
Ayer le gustaba A; hoy quiere B. Modificar el código en local, volver a hacer capturas, redactar el informe: un bucle infinito. Pasaba más tiempo escribiendo informes que desarrollando. El mundo al revés.
Lo vi clarísimo: «No se trata de enviar capturas de mi pantalla. Necesito un patio de juegos (un servidor de desarrollo) donde el responsable pueda entrar por su cuenta, pulsar todo lo que quiera e incluso romper cosas».
Las oportunidades llegan por casualidad: el redescubrimiento de un servidor abandonado
Justo durante la escisión de la empresa, por suerte, a nuestro equipo le asignaron un servidor ocioso (una máquina vacía). Sus especificaciones no eran gran cosa, pero tenía Linux instalado y una IP pública: un recurso valioso.
«Jefe, ¿puedo usar este servidor que sobra? Me gustaría montarlo como servidor para que el responsable del cliente pueda revisarlo todo por su cuenta».
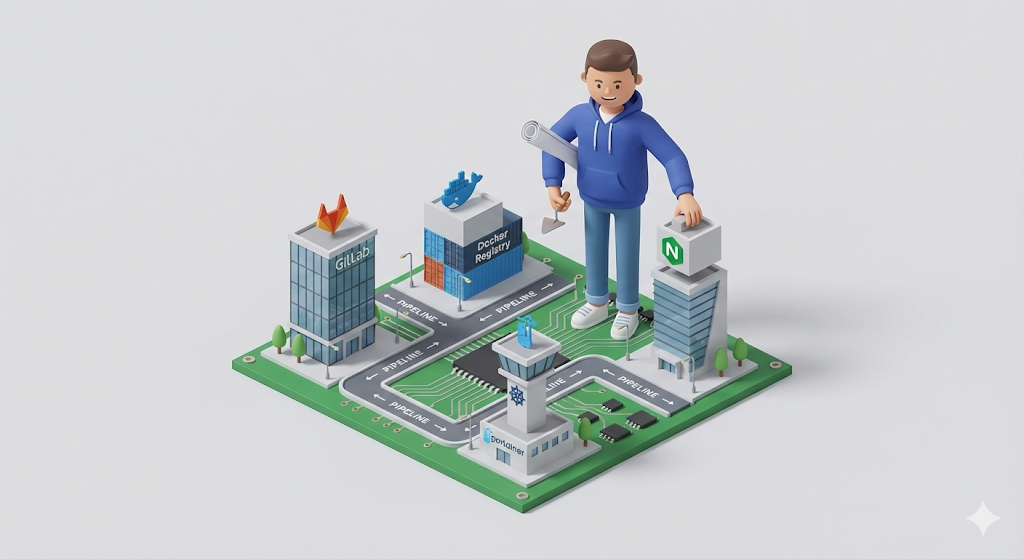
Me dieron permiso. Volqué en esa lata vacía todo lo que había aprendido hasta entonces y empecé a levantar mi «pequeño imperio de infraestructura propio». Era el resumen de todos mis meses de pelearme a base de prueba y error (las series Works on My Machine & The Pipeline).
- GitLab (repositorio de código): Instalo un repositorio privado para gestionar el código de forma segura.
- Docker Registry (repositorio de imágenes): Creo nuestro propio almacén para guardar las imágenes de Docker generadas.
- Portainer (gestión de contenedores): A alguien como yo, a quien la CLI le da miedo, le permite gestionar Docker con una GUI.
- Nginx (servidor web): Pongo un portero que dirige el tráfico de las peticiones hacia el frontend y el backend.
La solución: separar por completo los entornos (Dev vs Prod)
Ahora tenía dos escenarios (servidores). Para dar cabida a los caprichos del responsable sin dejar de proteger el servidor de producción, separé mi estrategia de despliegue en dos.
- Servidor de desarrollo (Development): «un laboratorio libre»
- El responsable no tiene ni tiempo de preguntar «¿Ya está?».
- En cuanto llega código a la rama
develop, el pipeline se ejecuta al instante y se hace un despliegue automático. - El responsable puede entrar cuando quiera en la URL del servidor de desarrollo, probar las funcionalidades y darme su opinión.
- Servidor de producción (Production): «un santuario verificado»
- Solo se despliega cuando el responsable declara: «¡Esta funcionalidad queda aprobada definitivamente!».
- El código se fusiona (Merge) en la rama
mastery solo se despliega cuando yo pulso el «botón de aprobación del despliegue» en GitLab (Manual).
[Code Verification] Poner orden con despliegues condicionales
GitLab CI permite definir una ruta de despliegue distinta para cada rama. Llevada al código, esta estrategia queda así:
stages:
  - build
  - deploy

# 1. Build (común)
build_job:
  stage: build
  script:
    - ./gradlew build
    - docker build -t my-reg/app:$CI_COMMIT_SHA .
    - docker push my-reg/app:$CI_COMMIT_SHA

# 2. Despliegue en el servidor de desarrollo (automático)
# En cuanto llega código a la rama 'develop', se despliega sin preguntar nada.
deploy_to_dev:
  stage: deploy
  script:
    - ssh user@dev-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-dev"
  only:
    - develop

# 3. Despliegue en el servidor de producción (aprobación manual)
# Aunque llegue código a la rama 'master', no se despliega hasta que yo pulse el botón.
deploy_to_prod:
  stage: deploy
  script:
    - ssh user@prod-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-prod"
  only:
    - master
  when: manual # ¡Clave! Solo se ejecuta 'si una persona pulsa el botón'.
Puntos clave:
only: - develop: la rama de desarrollo se despliega automáticamente, sin excepciones. Aquí la velocidad lo es todo.when: manual: la rama de producción lleva un seguro, porque una persona lo revisa una vez más antes de pulsar el botón.
Para terminar: por fin completo, «Vivo solo» en versión desarrollador
Ahora incluso yo, un desarrollador en solitario, tengo un sistema perfecto.
- Local: desarrollo de funcionalidades en mi máquina.
- Desarrollo (Dev): con un solo
git push, cinco minutos después ya está en el servidor de desarrollo. El responsable lo comprueba por sí mismo. - Producción (Prod): solo las funcionalidades aprobadas, reunidas y desplegadas con seguridad en un solo clic.
Ya no queda nada de aquel recién llegado que hacía horas extra abriendo la herramienta de capturas y anotando archivos HWP. Cuando el responsable me dice «¿Me cambia esto, por favor?», le contesto «Sí, ya lo he corregido y subido al servidor de desarrollo, échele un vistazo» y me tomo el café con toda la calma. Porque el sistema trabaja por mí.
Con esto cierro el largo proyecto [Re: Booting]. Desde los fundamentos de la informática hasta Linux, Docker y los pipelines de CI/CD. Espero que estos conocimientos, construidos a base de golpes y partiendo de cero, sirvan de pequeña luz a los «desarrolladores full stack por necesidad» que, en algún lugar, siguen luchando solos ahora mismo.