그 테이블은 누가 설계하지
지난 글은 질문 하나를 남기고 끝났다. 롤백에서도 살아남는 기록이라면, 그 기록이 눕는 테이블은 누가 설계하지? 적어도 ddl-auto는 아니었다.
고백하자면 나는 테이블을 거의 직접 만들어 본 적이 없다. 엔티티 클래스에 필드를 적으면 JPA의 ddl-auto가 알아서 CREATE TABLE을 날려 준다. 회원, 게시글, 주문처럼 행이 생기고 고쳐지고 지워지는 평범한 테이블이라면 그걸로 충분했다. 엔티티가 곧 설계도였으니까.
감사 로그 테이블은 성격이 달랐다. 내가 운영에 참여하는 시스템은 규제 산업에 속해 있어서, 감사 기록을 지우는 것 자체가 위험할 수 있다. 그래서 정책은 '영구 보존'이다. 행은 쌓이기만 하고 고쳐지지도 지워지지도 않는다. 그리고 ddl-auto는 엔티티의 필드는 알아도 이런 것은 모른다. 이 테이블이 얼마나 빨리 불어나는지, 사람들이 무엇을 기준으로 찾아보는지, 몇 년 뒤에 오래된 기록을 어떻게 덜어낼지. 그래서 이번에는 컬럼 목록보다 계산기를 먼저 꺼냈다.
컬럼보다 먼저 계산기를 꺼냈다
설계서의 첫 계산은 '얼마나 쌓이나'였다. 아래 표는 그때 적어 둔 가정과 결과 그대로다.
| 가정 | 값 |
|---|---|
| 한 행의 평균 크기 (JSONB 포함) | 1~3KB |
| 활성 사용자 | 500명 (가정, 실측 후 갱신) |
| 1인당 하루 쓰기 행위 | 20건 |
| 행위 1건당 감사 행 | 3건 (요청 기록 1 + 엔티티 변경 N) |
| 하루 | 약 3만 행, 30~90MB |
| 1년 | 약 1,100만 행, 11~33GB |
| 5년 | 약 5,500만 행, 55~165GB |
결론은 '감당할 수 있다'였다. PostgreSQL은 단일 테이블 수억 행까지 무난히 운영되는 데이터베이스라, 5년치를 쌓아도 그 범위 안이다. 영구 보존이라는 정책이 숫자로 정당화된 셈이다.
이 표에서 내가 가장 아끼는 부분은 결과가 아니라 가정 칸에 적힌 '(가정, 실측 후 갱신)'이다. 활성 사용자 500명은 어디까지나 추정이라, 설계서에는 조건을 하나 더 적어 두었다. 사용자가 5,000명처럼 가정과 크게 다르면 착수 전에 다시 계산하고, 파티션 단위를 월에서 주로 좁힐지 결정한다. 용량 산정은 미래를 맞히는 계산이 아니다. 어떤 숫자가 나오면 결정을 바꿀지를 미리 적어 두는 일이다.
이렇게 해서 첫 결정이 나왔다. 영구 보존, 그리고 월별 RANGE 파티셔닝.
기록 보관실의 서랍을 월별로 나누다
지난 글의 비유를 이어 가면, 감사 로그 테이블은 CCTV 테이프가 쌓이는 기록 보관실이다. 파티셔닝은 이 보관실의 서랍장을 월별 칸으로 나누는 일이다. 바깥에서 보면 테이블은 여전히 audit_log 하나다. 넣을 때도, 찾을 때도 audit_log에 대고 말한다. 하지만 실제 테이프는 occurred_at(발생 시각)이 속한 달의 서랍에 들어가고, 그 분류는 데이터베이스가 알아서 한다.
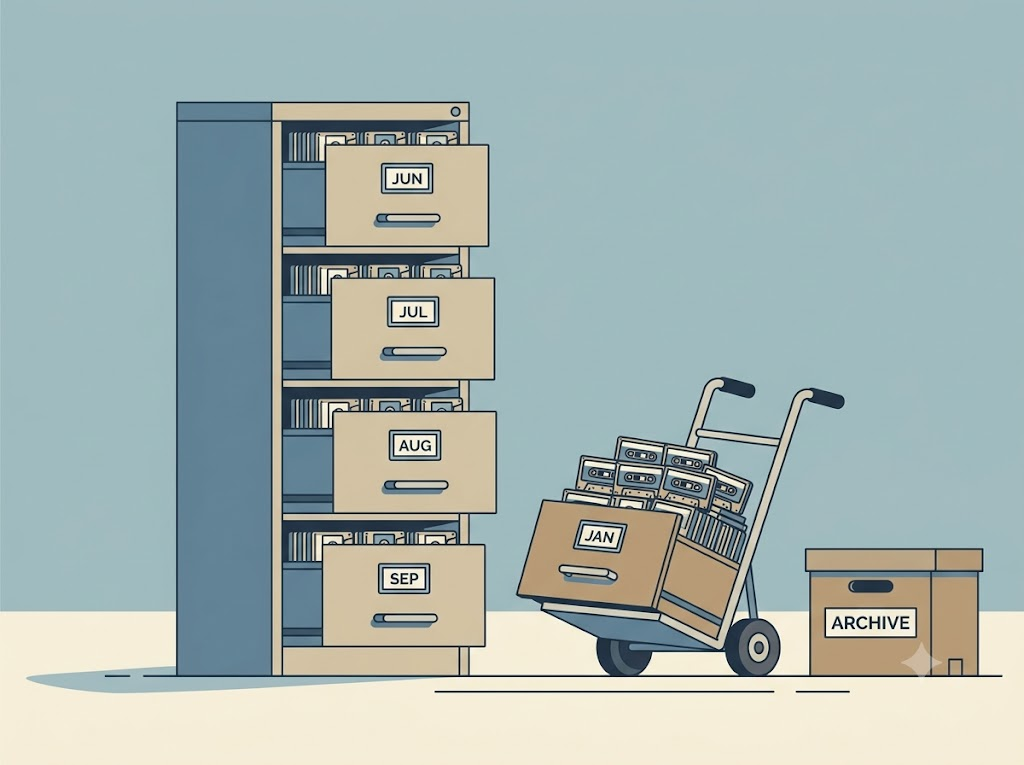
월별로 나누면 두 가지가 공짜로 따라온다.
첫째, 한 달치를 조회하면 그 달 서랍만 연다. 관리자 화면의 조회는 대부분 '최근 며칠' 같은 기간 조건이 붙는다. 이때 데이터베이스는 조건에 맞지 않는 달의 파티션을 아예 읽지 않는데, 이걸 파티션 프루닝이라고 부른다. 테이블이 5년치로 불어나도 이번 달 조회 비용은 이번 달 크기만큼만 든다.
둘째, 언젠가 오래된 기록을 덜어내야 할 때 수천만 행을 DELETE할 필요가 없다. 해당 월의 파티션을 부모 테이블에서 떼어내면(DETACH) 끝이다. 재현 데모에서도 6월 파티션을 떼어내자 부모 테이블의 목록에서는 빠졌지만, 그 안의 행은 그대로 남아 있었다. 떼어낸 파티션은 평범한 테이블로 남으니, 외부로 백업하고 무결성을 확인한 다음에야 지운다. 운영 중에 아무 파티션이나 TRUNCATE하거나 DROP하는 건 금지로 못 박아 두었다. 감사 기록의 신뢰는 '절대 임의로 지우지 않는다'는 약속에서 나오기 때문이다.
뼈대를 SQL로 옮기면 이렇다. 실제 테이블에서 컬럼을 줄인 형태다.
CREATE TABLE audit_log (
    id            BIGSERIAL    NOT NULL,
    occurred_at   TIMESTAMP    NOT NULL DEFAULT NOW(),
    trace_id      UUID         NOT NULL,   -- 한 HTTP 요청의 변경 묶음
    actor_id      BIGINT,
    request_uri   TEXT,
    diff          JSONB,                   -- {"필드": {"before": ..., "after": ...}}
    status        VARCHAR(16)  NOT NULL,   -- SUCCESS / FAIL
    error_message TEXT,
    PRIMARY KEY (id, occurred_at)          -- 파티션 키는 PK에 포함돼야 한다
) PARTITION BY RANGE (occurred_at);

-- 월별 파티션: 해당 월의 행만 받는 자식 테이블
CREATE TABLE audit_log_2026_09 PARTITION OF audit_log
  FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');
두 번째 블록이 중요하다. 파티션 테이블은 '그 달의 서랍'이 미리 있어야 행을 받는다. 이 문장이 이 글의 후반부를 통째로 끌고 간다.
첫 번째 거절: PK에 날짜를 넣어라
ddl-auto 시절의 나에게 PK는 늘 id 하나였다. 그런데 앞의 DDL은 PRIMARY KEY (id, occurred_at)이다. 파티션 테이블에서는 id 하나짜리 PK가 통하지 않기 때문이다. 로컬에 같은 패턴을 재현해 PK를 id 하나로 선언해 보면 PostgreSQL은 테이블 생성 자체를 거절한다.
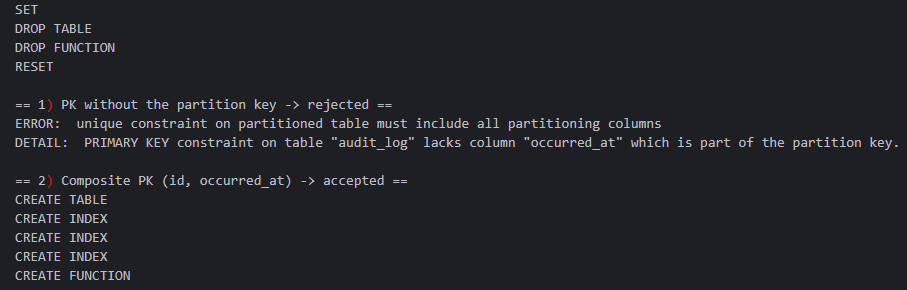
이유는 서랍장 구조에 있다. 파티션 테이블에서 유일성 검사는 파티션마다 따로 이뤄진다. 각 서랍이 자기 색인 카드만 갖고 있는 셈이라, 9월 서랍은 8월 서랍에 같은 id가 있는지 모른다. 그런데 키에 파티션 키가 들어 있으면 이야기가 달라진다. (id, occurred_at)이 같은 행은 반드시 같은 달 서랍에 들어가므로, 서랍마다 검사해도 테이블 전체에서 유일하다는 게 보장된다. 그래서 PostgreSQL은 '파티션 키를 포함하지 않는 유일 제약'을 처음부터 받아 주지 않는다.
DB 쪽은 이걸로 끝났는데, 이 복합 키가 JPA 쪽에서 한 번 더 발목을 잡았다. @Id가 둘이 되면 키 클래스를 따로 두고 @IdClass로 묶어야 한다. 여기까지는 교과서대로다. 문제는 occurred_at을 자동으로 채우려고 붙인 @CreationTimestamp였다. 애플리케이션이 아예 뜨지 않았다.
@Entity
@IdClass(AuditLogId.class)   // 복합 PK (id, occurredAt)
public class AuditLog {

    @Id
    @GeneratedValue(strategy = GenerationType.SEQUENCE, generator = "audit_gen")
    private Long id;

    @Id
    // @CreationTimestamp  ← 부팅 실패:
    //   NotYetImplementedException: composite in-memory value generation
    private Date occurredAt;  // 대신 빌더에서 null이면 new Date()로 채운다
}
Hibernate 5.x는 복합 PK의 구성 요소에 붙은 '메모리에서 값을 만들어 주는' 생성기를 아직 지원하지 않는다. 그래서 @CreationTimestamp를 떼고, 엔티티를 만드는 빌더 단계에서 값이 비어 있으면 현재 시각을 넣는 방식으로 바꿨다. ddl-auto가 테이블을 만들던 시절에는 엔티티가 테이블을 결정했다. 이번에는 반대였다. 데이터베이스의 제약이 키를 결정했고, 엔티티는 그 결정을 따라가야 했다.
컬럼은 질문에서, 인덱스는 조회에서
컬럼 중 눈여겨볼 것은 diff다. 무엇이 바뀌었는지를 {“필드”: {“before”: …, “after”: …}} 모양으로 담는데, 바뀌는 필드는 엔티티마다 다르다. 수확 기록과 포장 기록의 필드가 같을 리 없다. 엔티티마다 컬럼을 만들 수는 없으니 스키마 없이 담을 수 있는 JSONB로 했다. 요청 파라미터도 민감정보를 가린 뒤 JSONB로 저장하고, 둘 다 32KB를 넘으면 원문 대신 {“truncated”: true, “size”: N}만 남긴다. 영구 보존 테이블에서 한 행이 비대해지는 건 매일 3만 번 반복되는 비용이기 때문이다.
JSONB 안을 검색하려면 GIN 인덱스가 필요하다. 하지만 아직 그런 검색을 하는 화면이 없으니 만들지 않았다. 설계서에는 '필요해지면 추후 추가'라고만 적어 두었다. 인덱스는 공짜가 아니다. 쓰기마다 갱신 비용을 내고, 쓰기가 전부인 테이블에서는 그 비용이 그대로 쌓인다.
일반 인덱스는 반대 방향에서 설계했다. 관리자가 이 테이블에 던질 질문을 먼저 적고, 질문마다 인덱스를 하나씩 역산했다.
| 관리자의 질문 | 인덱스 |
|---|---|
| 최근 기록부터 보여 달라 | (occurred_at DESC) |
| 이 사용자는 언제 무엇을 했나 | (actor_id, occurred_at DESC) |
| 이 클릭 한 번에 무엇이 바뀌었나 | (trace_id) |
| 이 API로 들어온 변경은 | (request_uri, occurred_at DESC) |
| 이 데이터는 누가 언제 바꿨나 | (entity_name, entity_id) |
| 이 기관의 활동은 | (actor_corp_id, occurred_at DESC) |
복합 인덱스의 컬럼 순서에도 규칙이 있다. '누가'처럼 같다(=)로 찾는 컬럼을 앞에, '언제부터 언제까지'처럼 범위로 찾는 컬럼을 뒤에 둔다. 그래야 인덱스 안에서 한 사용자의 기록이 시간순으로 붙어 있게 된다.
그리고 파티션 테이블에서 인덱스는 부모 테이블에 한 번만 선언하면 된다. 새 달의 파티션이 생길 때마다 같은 인덱스가 그 파티션에도 자동으로 만들어진다. 재현 데모에서 9월 파티션의 인덱스 목록을 확인하고, 9월 한 달치를 사용자 조건으로 조회해 실행 계획을 보면 이렇다.
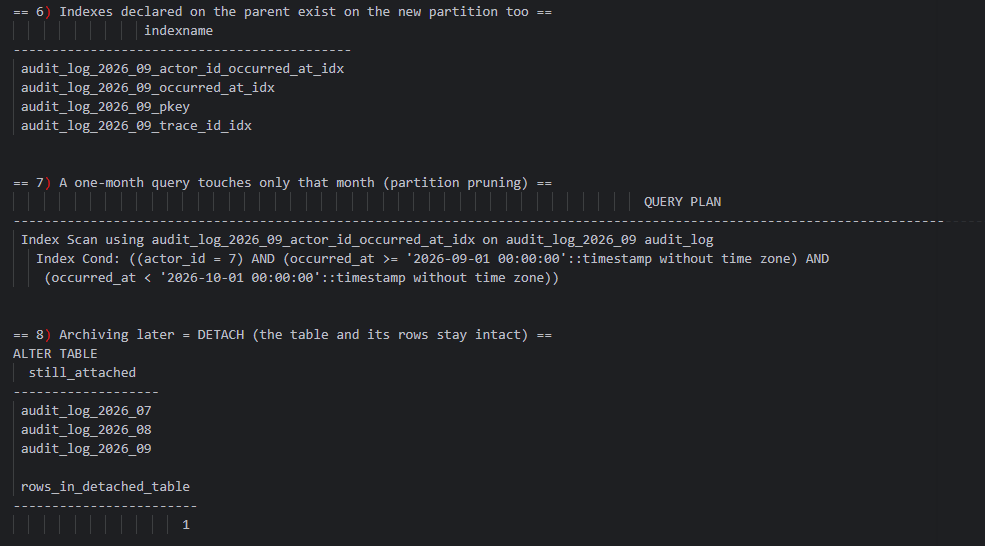
실행 계획에 다른 달의 파티션은 하나도 없다. 9월 파티션 하나에서, 그것도 (actor_id, occurred_at) 인덱스로 '사용자 7의 9월치'만 집어 왔다. 표의 두 번째 질문이 정확히 이렇게 처리된다.
설계서가 경고한 그 장애: 9월 1일 자정
다시 그 문장으로 돌아가자. 파티션 테이블은 그 달의 서랍이 미리 있어야 행을 받는다. 설계서에도 이렇게 적혀 있었다. '파티션이 없으면 INSERT가 실패하므로 운영 자동화 필수.'
대비도 했다. 배포용 DDL에는 월을 받아 그 달의 파티션을 만드는 함수 audit_log_ensure_partition()을 넣었다. 이미 있으면 아무것도 하지 않는 멱등 함수다. 그리고 실행 시점 기준으로 이번 달과 다음 두 달의 파티션을 만드는 블록을 함께 넣었다. 6월에 배포했으니 6·7·8월 서랍이 생겼다. 그다음부터는 운영 절차서대로, 매월 25일 서버의 cron이 다음 두 달의 파티션을 보장하기로 되어 있었다.
그 cron은 등록되지 않았다.
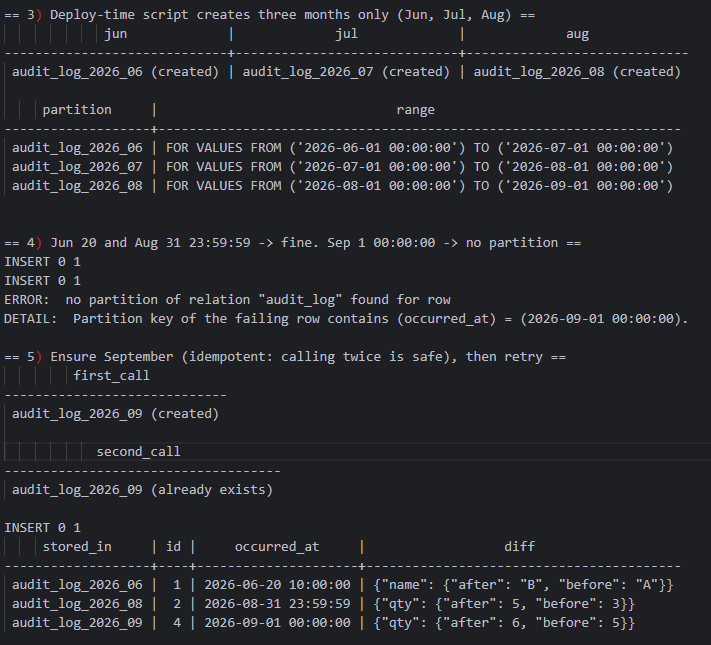
9월 1일 0시부터 모든 감사 로그 INSERT가 실패했다. 오류는 한 줄이었다. no partition of relation “audit_log” found for row. 9월 서랍이 없으니 9월의 테이프를 둘 곳이 없었던 것이다. 같은 상황을 재현하면 이렇다.
더 서늘한 건 비즈니스 쪽이 멀쩡했다는 점이다. 지난 글에서 감사 로그를 별도 트랜잭션(REQUIRES_NEW)으로 떼어 냈고, 저장이 실패해도 예외를 삼켜 본 업무는 그대로 진행되게 만들었다. 감사 로그 때문에 업무가 멈추는 일은 없어야 하니까. 그 안전장치가 그대로 작동했다. 업무는 정상이었고, 감사 기록만 소리 없이 사라졌다. 설계 단계에서 '조용한 손실'이라는 이름으로 예고했던 유형이 실제로 일어난 첫 사례였다.
응급 조치는 간단했다. 함수를 세 번 불러 9·10·11월 파티션을 만들자 적재가 바로 재개됐다. 하지만 9월 1일 0시부터 복구 시점까지의 기록은 돌아오지 않는다. 처음부터 저장되지 않은 기록은 복구할 원본이 없다.
재발 방지에서 고친 것은 cron이 아니라 구조였다. 사람이 무언가를 등록해야 돌아가는 자동화는 결국 사람이 잊는 날 멈춘다. 그래서 애플리케이션이 파티션을 스스로 챙기게 했다. 기동 직후에 한 번, 그리고 매일 0시 30분마다 이번 달과 다음 두 달의 파티션을 보장한다. 문서에 남긴 동작을 코드로 옮기면 골격은 이렇다.
@Component
@RequiredArgsConstructor
public class AuditPartitionScheduler {

    private final AuditLogRepository auditLogRepository;

    @EventListener(ApplicationReadyEvent.class)  // 기동 직후 1회
    @Scheduled(cron = "0 30 0 * * *")            // 그리고 매일 00:30
    public void ensurePartitions() {
        try {
            LocalDate today = LocalDate.now();
            for (int i = 0; i <= 2; i++) {        // 이번 달 + 다음 2개월
                auditLogRepository.ensurePartition(today.plusMonths(i)); // SELECT audit_log_ensure_partition(:date)
            }
            log.info("[audit] partitions ensured");
        } catch (Exception e) {
            log.error("[audit] partition ensure failed", e);  // 비즈니스에는 영향 없음
        }
    }
}
백엔드가 떠 있는 한 파티션은 유지된다. 배포나 재기동 직후에도 바로 보정된다. 서버 cron은 버리지 않고, 백엔드가 오래 내려가 있는 특수한 경우를 위한 이중 안전망으로 강등했다.
재현 데모의 출력에는 덤이 하나 있다. 9월 행의 id가 2 다음 3이 아니라 4다. 실패한 INSERT도 시퀀스에서 번호는 뜯어 간다. 그래서 감사 로그의 빈 번호를 세어서 유실 규모를 셀 수는 없다. 실제 장애의 손실 범위도 '몇 번부터 몇 번'이 아니라 '9월 1일 0시부터 복구 시점까지'라는 시간으로 적었다.
ORM이 만든 테이블과 운영을 고려해 설계한 테이블
돌아보면 ddl-auto가 틀렸던 건 아니다. 묻지 않았을 뿐이다. 두 방식이 출발하는 질문을 나란히 놓으면 차이가 보인다.
| ddl-auto가 만든 테이블 | 직접 설계한 감사 로그 테이블 | |
|---|---|---|
| 출발점 | 엔티티의 필드 | 쌓이는 양, 보존 기간, 조회 질문 |
| 키 | @Id 하나 | DB 제약에서 출발한 복합 PK |
| 인덱스 | PK 정도 | 조회 질문에서 역산한 6개 |
| 수명 | 만들면 끝 | DETACH부터 백업, 삭제까지의 절차 |
| 운영 | 없음 | 파티션 선행 생성과 실패 감시 |
이번 일로 내가 챙기게 된 습관은 네 가지다.
- 파티션을 쓸 거라면 엔티티를 쓰기 전에 키부터 정한다. 파티션 키는 PK에 들어가고, 그 결정은 JPA 매핑까지 내려간다.
- 미리 만들어야 하는 것은 사람 손이 아니라 애플리케이션이나 데이터베이스 안에서 만들게 한다. 절차서에만 있는 자동화는 체크리스트다.
- 실패해도 업무를 막지 않는 기록일수록 실패를 따로 지켜본다. 감사 로그는 조용히 죽기 때문에, 화면의 수집 상태 표시와 실패 건수를 정기적으로 확인하는 일까지가 설계에 포함된다.
- 용량을 계산할 때는 '이 가정이 틀리면 무엇을 바꿀지'까지 적어 둔다.
마치며: 엔티티가 묻지 않는 질문들
ddl-auto는 엔티티가 무엇을 담는지는 묻지만, 얼마나 쌓일지, 누가 무엇으로 찾을지, 언제 어떻게 덜어낼지는 묻지 않는다. 오래 사는 테이블일수록 그 질문들이 설계의 대부분이다. 이번 DDL은 그 질문에 하나씩 답을 적어 나간 결과였다. 그리고 그 답 중 하나는 '서랍은 미리 만들어 둔다'였는데, 그 답을 절차서에만 적어 둔 대가는 9월 1일에 치렀다.
CREATE TABLE과 제약 조건, 복합 키, 인덱스 설계는 SQLD에서도 다루는 내용이다. DDL과 인덱스를 정리한 노트는 공부 노트 저장소에 있다.
사실 이 DDL의 첫 버전에는 지금과 다른 줄이 몇 개 있었다. 사용자 계정이나 IP를 담는 칸에 별생각 없이 적어 둔 VARCHAR(64) 같은 것들이다. 그 64라는 숫자는 대체 어디서 나왔을까.