정보처리기사 실기 2026년 3회 후기를 남긴다. 4월 1회 실기에서 떨어졌고, 7월 2회는 준비가 부족해 접수만 하고 넘겼다. 3회를 앞둔 마지막 이틀은 새 개념을 넓게 보기보다 '기출이 어떻게 다시 나오는지'를 데이터로 확인하고, 그에 맞춰 공부 순서를 다시 짜는 데 썼다. 결과부터 말하면 가채점은 20문항 중 13개, 65점이다. 이 글은 그 이틀 동안 확인한 것과 시험장에서 실제로 맞고 틀린 것의 기록이다.
시험 직전, 2회 복원 문제를 실전처럼 풀었다
먼저 지금 실력이 어디쯤인지 알아야 했다. 2026년 2회 복원 20문항을 시험처럼 한 번에 풀고, 문항마다 왜 그렇게 답했는지 메모를 남겼다. 점수는 11개, 55점이었다. 그런데 메모를 다시 보니 맞힌 11개 중 4개는 단어만 보고 찍은 것이었다. 실력으로 맞힌 건 7개였다.
| 영역 | 문항 | 실력으로 맞힘 | 찍어서 맞힘 | 틀림 |
|---|---|---|---|---|
| C·Java·Python | 7 | 6 | 0 | 1 |
| SQL | 4 | 1 | 0 | 3 |
| 이론 | 9 | 0 | 4 | 5 |
틀린 이유가 메모에 그대로 남아 있었다.
- RIGHT OUTER JOIN을 '왼쪽 A 기준'으로 이해해서 0이라고 썼다. 오른쪽 B가 기준이다.
- 값의 허용 범위를 검사하는 CHECK 자리에 '중복 검사 같은 느낌'이라며 DISTINCT를 썼다.
- 링크 상태 라우팅 프로토콜(OSPF)을 묻는 문제에 DNS를 썼다.
- Python
dict.items()가 키를 정렬해 준다고 생각했다. - SRT 스케줄링에서 프로세스 순서는 맞게 잡았는데, 대기시간 대신 종료 시각을 더했다.
- '프리픽스'가 CIDR의
/뒤 숫자라는 걸 몰랐다.
인프라 운영 일을 해 왔으니 네트워크는 강점이라고 생각했는데, 네트워크·OS 네 문항 중 실력으로 맞힌 게 하나도 없었다. 서버를 다루는 경험과 시험이 묻는 용어·계산은 별개였다. 반대로 코딩은 7문항 중 6개를 맞혔다. 남은 이틀은 SQL과 이론에 쓰기로 했다.
이론 노트를 읽을 시간은 없었다, 그래서 기출을 분류했다
이론 노트를 처음부터 읽을 시간은 없었다. 대신 '시험이 실제로 무엇을 반복하는가'를 확인하기로 했다. 문어CBT에 복원된 2020년 1회부터 2026년 2회까지 21회차, 420문항을 모아 주제별로 분류했다. 수집과 분류, 코드 문제의 실행 검증은 Claude Code로 했다. 키워드로 자동 분류하면 Land Attack이 네트워크로, OSPF가 디자인 패턴으로 들어가는 식으로 많이 틀려서, 이론 문항 230여 개는 하나씩 주제를 다시 매겼다.
확인하고 싶은 질문은 두 가지였다.
- 예전 기출이 얼마나 그대로 다시 나오는가.
- 커뮤니티에 돌던 “1·2회에 서브넷이 나왔으니 3회엔 안 나온다”는 말이 맞는가.
발견 1: 2026년 이론·SQL의 3분의 2가 예전 기출이었다
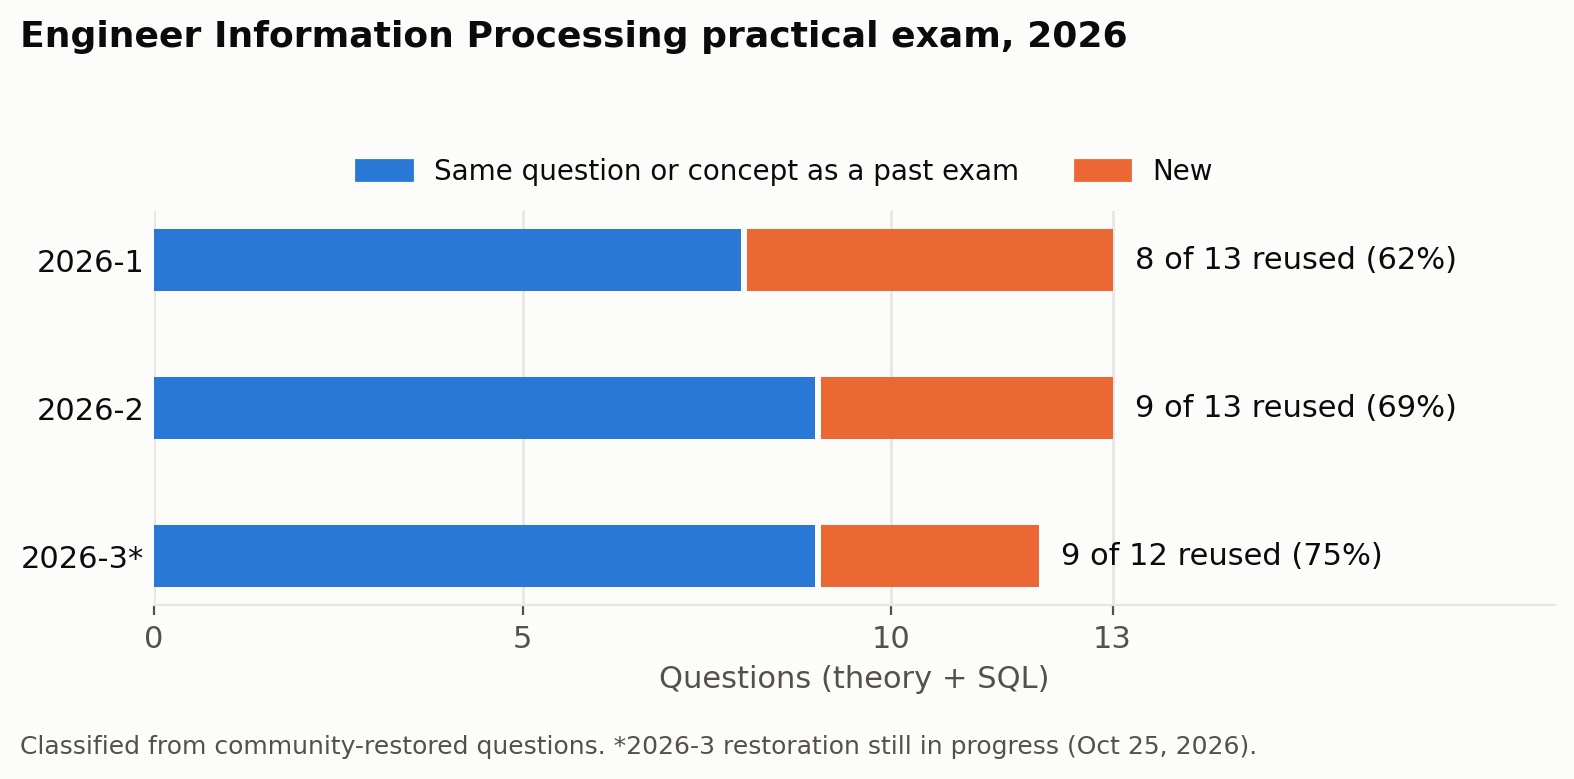
2026년 각 회차의 이론·SQL 문항을 예전 21회차와 하나씩 맞춰 봤다. 같은 문제이거나 같은 개념을 같은 방식으로 묻는 문항이 절반을 훌쩍 넘었다. 3회는 시험이 끝난 뒤 수험생 복원 기준으로 같은 방식으로 셌다.
몇 가지는 데이터까지 같았다.
- 2024년 2회의 SRT 문제 데이터(P1 0/8, P2 1/4, P3 2/9, P4 3/5)가 2025년 2회에 RR(퀀텀 4) 문제로, 2026년 2회에 다시 SRT 문제로 나왔다.
- 2024년 1회 한 회차에서 2026년 2회로 네 문제가 넘어왔다. IP 할당 그림, 정규형 판정 표, OSPF, Abstract Factory다.
- 학과별 학생 수를 주고
SELECT DEPT,SELECT DISTINCT DEPT,COUNT(DISTINCT DEPT)의 행 수를 묻는 문제는 2020년 1회, 2022년 3회, 2026년 1회에 세 번 나왔다.
새로 나온 것은 주로 SQL 문법(RIGHT OUTER JOIN, 상관 서브쿼리, CREATE DOMAIN)과 몇 개의 처음 보는 용어(심볼릭 링크, 프리픽스)였다. 그래서 방향을 정했다. 이론은 노트를 정독하는 대신 예전 기출의 '설명 → 답' 짝을 외우고, SQL은 새 문법이 계속 나오니 원리부터 다시 잡는다.
발견 2: “방금 나온 주제는 쉰다”는 말은 데이터와 반대였다
서브넷만 보면 커뮤니티 말에 근거가 있어 보였다. 서브넷 계산은 2022년 2·3회에 연속으로 나온 뒤 2023년 1회에 빠졌고, 2025년 1·2회에 연속으로 나온 뒤 2025년 3회에 빠졌다. 두 번 다 그랬다. 하지만 사례가 두 개뿐이라 우연과 구분할 수 없었다.
그래서 이론 주제 전체로 넓혀 봤다. 28개 주제가 19번의 회차 전환을 거치는 532건에서, 직전 두 회차에 그 주제가 나왔는지에 따라 다음 회차에 나온 비율을 셌다.
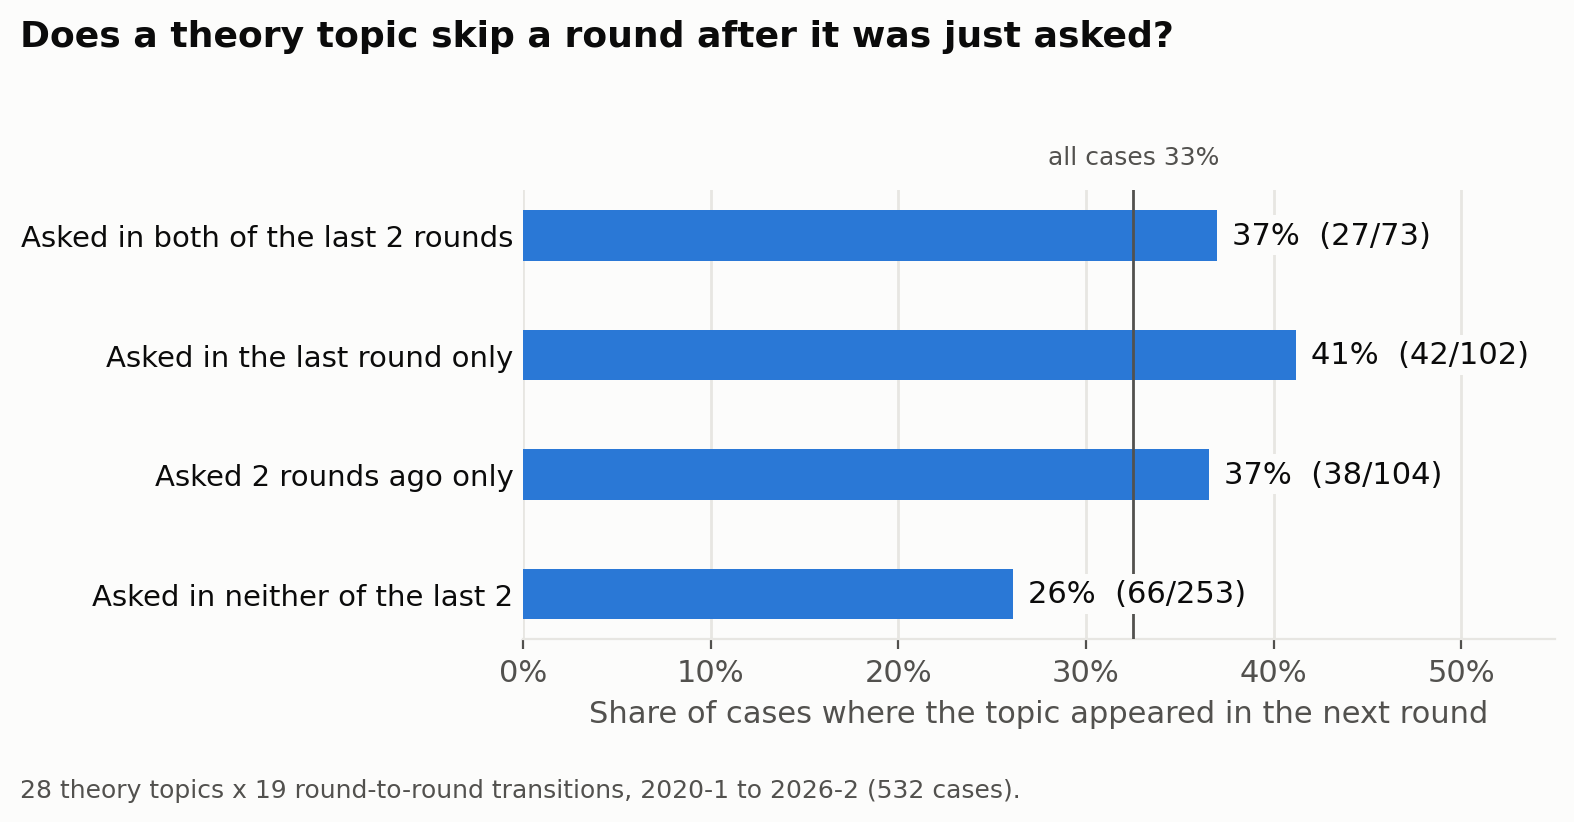
결과는 반대였다. 최근에 나온 주제가 다음 회차에도 더 잘 나왔고, 두 회차 연속으로 쉰 주제가 가장 덜 나왔다(26%). 출제진이 직전에 낸 주제를 일부러 피한다고 볼 근거는 없었다.
서브넷은 버리지 않았다. 네트워크 주소, 브로드캐스트, 호스트 수, 프리픽스가 한 가지 계산 순서(프리픽스 → 블록 크기 → 배수로 내림 → 다음 시작 −1 → 양 끝 빼기)로 다 풀려서, 30분짜리 보험으로 두었다. 실제 3회 10번에는 2022년 3회의 FLSM 문제가 그대로 나왔다.
이틀 동안 한 것
이론은 2020~2025년 기출 이론 문항 140개를 주제별로 묶고, 문제 문장을 짧게 다시 써서 '설명 → 답' 카드로 만들었다. 여기에 결합도·응집도 순서 카드 2장과 SQL 문법 골격 18장을 더해 160장이 됐다. 출제 빈도가 높은 주제와 여러 번 나온 문항만 추린 46장은 '생존 세트'로 따로 묶었다.
처음에는 답을 가리고 풀었는데 140개 중 13개만 썼다. 노트를 거의 안 본 상태에서 가리고 푸는 건 시험이 아니라 확인이었다. 그래서 정답을 펼쳐 놓고 '설명 → 답'을 소리 내어 읽는 방식으로 바꿨다. 1회독은 읽기, 2회독은 답을 가리고 말하기, 3회독은 틀린 것만이다.
SQL은 2회에서 틀린 지점부터 기초 문제로 다시 풀었다. JOIN 방향, 상관 서브쿼리, 제약 조건 키워드, NULL이다. 풀면서 굳은 그림이 하나 있다.
CROSS JOIN   모든 조합을 만든다 (행 수 곱하기)
INNER JOIN   그중 ON이 참인 쌍만 남긴다 (ON은 '='가 아니어도 된다)
OUTER JOIN   짝이 없어 빠진 행을 되살리고 반대쪽을 NULL로 채운다
이 그림 하나로 중복 키가 행을 불리는 이유, NULL = NULL이 짝이 되지 않는 이유, ON A.팀 < B.팀이 대진표 10쌍을 만드는 이유가 다 설명됐다.
마지막으로 실전 모의고사를 하나 더 골랐다. 기준은 합격률 흐름이었다. 1회 합격률이 아주 높았던 해에는 그해 3회가 떨어졌다. 2024년은 1회 36.8%에서 3회 20.7%로, 2021년은 1회 39.5%에서 3회 23.6%로 내려갔다. 2026년은 2회가 34.7%로 높았다. 그래서 같은 흐름의 가장 최근 회차인 2024년 3회를 골랐다. 결과는 11개였다. 틀린 이론 6개 중 5개가 이미 카드에 있던 문항이었고, 코딩에서는 Java 바인딩 두 문제를 틀렸다. 하나는 '필드는 변수 타입, 메서드는 실제 객체 기준'이고, 다른 하나는 '오버로딩은 컴파일할 때 선언 타입으로 고른다'였다.
3회 결과: 가채점 13/20
3회 복원 기준 출제 분포는 C 3, Java 3, Python 2, SQL 3, 이론 9문항이었다. 이론 9문항 중 8문항이 예전 기출과 같은 문제나 개념이었고, 2022년 3회에서만 세 문제(경계값 분석, FLSM 서브넷, UML 구성 요소)가 다시 나왔다. 처음 보는 용어는 SBOM 하나였다. 문항 번호는 10월 26일에 바뀐 복원 번호를 따른다. 문항별 정답과 풀이는 정보처리기사 실기 2026년 3회 정답과 해설에 따로 정리했다.
| 영역 | 문항 | 맞힘 | 틀린 문항 |
|---|---|---|---|
| C·Java·Python | 8 | 7 | 15번 (Java 2차원 배열) |
| SQL | 3 | 3 | |
| 이론 | 9 | 3 | 6 IDEA·Skipjack, 7 경계값 분석, 8 RBAC, 10 FLSM, 11 인터페이스, 18 SBOM |
이틀 동안 바꾼 것이 점수로 이어진 장면이 셋 있었다.
- 16번 루트킷: 카드에서 외운 '존재를 숨기고 관리자 권한을 유지하는 도구'라는 단서로 바로 떠올렸다.
- 14번
a + super.a: 전날 모의고사에서 틀린 바인딩 규칙(메서드는 실제 객체 기준)을 그대로 적용했다. - 12번: 처음엔 생각 없이 170을 썼다가, 제출 전에 다시 훑으면서
AMOUNT < (평균)의<를 보고 130으로 고쳤다.
놓친 것도 분명했다. 6번 IDEA·Skipjack은 2022년 2회 문제와 같았는데 카드에서 빠져 있던 문항이었다. 10번 FLSM은 보험으로 두겠다던 계산 순서를 끝내 돌려 보지 않은 대가였다. 15번은 Python 얕은 복사와 같은 원리가 Java 배열로 나온 문제였다.
int[][] a = {{0}, {1}, {2}};
int[][] b = new int[3][];
for (int i = 0; i < a.length; i++) {
    b[i] = a[i];          // copies the reference to each row
}
a[1] = new int[]{9};      // replaces a's slot only
b[2][0] = 3;              // modifies the shared row
System.out.println(a[2][0] + " 그리고 " + b[1][0]);   // 3 그리고 1
나는 '3 그리고 9'라고 썼다. b[i] = a[i]는 b[1]을 'a[1]이라는 칸'에 묶는 게 아니라, 그 순간 a[1]이 가리키던 행의 주소를 복사해 둔다. 그래서 a[1]에 새 배열을 갈아끼워도 b[1]은 옛 행을 가리킨다. 반대로 b[2][0] = 3은 공유 중인 행 안을 고친 것이라 a에서도 보인다. Python의 얕은 복사가 2026년 1회에 처음 나왔는데, 3회에는 같은 원리를 Java로 물은 셈이다.
5번 논쟁: 7인가 13인가
시험이 끝난 뒤 복원 게시판에서 의견이 갈린 문제가 C 5번이다(처음 복원 때는 16번이었다). 구조체 배열에 {3, add}, {10, sub}를 넣고 포인터를 앞뒤로 옮긴 뒤 함수 포인터로 계산하는 문제였다. 처음 복원된 코드의 핵심은 이렇다.
Item arr[2] = {{3, add}, {10, sub}};
Item *p = arr;

p++;
int a = p->value;                      // 10
int (*ptr)(int, int) = p->fn;          // sub

p--;
int b = p->value;                      // 3

printf("%d", ptr(a, b));               // sub(10, 3) = 7
“포인터로 받았으니 p를 따라가서 add가 불리고 13이다”라는 주장이 있었다. 코드 순서에 따라 답이 갈리는지 네 가지로 바꿔서 직접 돌려 봤다(재현).
/* A: function pointer saved before p-- (the restored code) */
int (*fn_ptr)(int, int) = p->fn;  p--;   ...  fn_ptr(a, b)
/* B: struct pointer saved before p-- */
Item *fn_ptr = p;                 p--;   ...  fn_ptr->fn(a, b)
/* C: struct pointer saved after p-- */
p--;   ...  Item *fn_ptr = p;            ...  fn_ptr->fn(a, b)
/* D: pointer to p itself */
Item **fn_ptr = &p;               p--;   ...  (*fn_ptr)->fn(a, b)
$ for f in A B C D; do gcc -Wall -std=c11 -o $f $f.c && echo "[$f] $(./$f)"; done
[A] 7
[B] 7
[C] 13
[D] 13
포인터 변수도 대입하는 순간의 주소를 복사해 둘 뿐이라, 그 뒤에 p를 옮겨도 따라가지 않는다(A, B). 13이 나오려면 대입이 p-- 뒤에 있었거나(C), p 자체의 주소를 담는 이중 포인터여야 한다(D). 10월 25일까지 1위 복원은 A의 순서였고, 26일에 확정된 복원은 구조체 포인터를 p-- 전에 저장하는 B로 바뀌었다. 코드 모양은 바뀌었어도 답은 둘 다 7이다. 다만 확정된 복원에도 반대 표가 11개 붙어 있다. 실제 시험지의 순서는 아무도 확인할 수 없으니, 이 문제는 '어떤 순서면 어떤 답인가'까지만 말할 수 있다.
다음 응시자에게
이번 회차를 겪고 나서 다음 시험을 준비한다면 이렇게 하겠다.
- 이론은 노트보다 기출의 '설명 → 답'이다. 최근 3개년만 보면 안 된다. 이번 3회는 2022년 3회에서 세 문제를, 2021년 3회와 2022년 2회에서도 한 문제씩 가져왔다.
- SQL은 결과를 표로 적는다. 'CROSS → INNER → OUTER' 그림과 NULL 규칙 세 줄이면 대부분 풀린다. NULL과 비교하면 행이 사라지고, 집계는 NULL을 빼고 세며,
COUNT(*)만 예외다. - 코딩은 언어가 바뀌어도 같은 질문이 반복된다. “칸을 갈아끼우나, 가리키는 것 안을 고치나”는 Python 얕은 복사, Java 배열, C 포인터에 모두 통했다. Java는 바인딩 규칙 세 줄(메서드는 실제 객체, 필드는 변수 타입, 오버로딩은 선언 타입)이다.
- 시험장에서는 SELECT 절과 '몇 개를 묻는지'부터 확인하고, 제출 전에 비교 기호를 한 번 더 본다. 12번은 그 한 번으로 살렸다.
마치며: 합격 발표를 기다리며
1차 발표는 12월 11일, 최종 발표는 12월 18일이다. 가채점은 13개다. 복원은 10월 26일에 20문항 중 17문항이 확정됐고, 정답은 처음 복원과 모두 같았다. 다만 2번은 답 배치를 어떻게 썼는지 기억이 확실하지 않아 보수적으로 잡으면 12개다. 1회 때와 달라진 점은 하나다. 무엇이 다시 나올지를 데이터로 확인하고 들어갔다.
정처기 다음은 미뤄 둔 AWS Solutions Architect Associate다. 이 블로그는 지금 클라우드 서버 한 대 위에서 돌아간다. 이 서버를 교재로 삼으면, SAA 범위 중 얼마만큼이 실제로 손에 잡힐까?