Anche il giorno in cui l’azienda si è dissolta, le richieste di bug fix hanno continuato ad arrivare
Sei mesi dopo il mio ingresso in azienda, nel giorno in cui l’organizzazione è andata in pezzi per motivi interni e solo il nostro team è rimasto a galla da solo, l’ufficio era nel caos. Il mio team leader mi ha detto: “Ormai non capisco più bene la parte tecnica, quindi adesso devi fare tutto tu”, e mi ha affidato piena autorità sulla gestione dell’infrastruttura.
Anche in mezzo a quella confusione, il telefono continuava a squillare. Era un cliente. “Scusi, c’è un errore nella pagina di login. Ce lo sistemate in fretta?”
Mi si è annebbiata la mente. Prima, se correggevo tutto in locale e facevo semplicemente un git push, Jenkins o GitLab sul server di un altro reparto distribuivano automaticamente tutto sul server di produzione. Ma quel collegamento si era spezzato.
Adesso non c’era più nessun “robot di deployment” ad aiutarmi. Dovevo portare quel codice fino al server di produzione con le mie mani. Era opprimente. Però, in quel momento, nella mia testa sono passate tutte le conoscenze che avevo imparato nei mesi precedenti, sbattendo la testa contro i problemi uno dopo l’altro.
“Aspetta, calma. Se capisco il principio, posso farlo anche a mano. Portiamolo in sicurezza, un passo alla volta.”
Git e GitLab: il deposito del codice
Per prima cosa dovevo ricostruire il ponte che si era spezzato. Le prime cose di cui avevo bisogno erano “Git” e “GitLab”.
- Git: è lo strumento che conserva il mio codice e ne gestisce le versioni (la storia). (Una macchina del tempo)
- GitLab: è una piattaforma che, oltre alle funzioni di repository Git, riunisce in un unico prodotto anche gli strumenti di automazione del deployment (CI/CD).
“Di solito non si usa di più GitHub?” Sì, è vero. In generale il più usato è GitHub, con GitHub Actions, e alcuni team costruiscono e usano anche separatamente il tradizionale peso massimo, Jenkins.
Ma noi lavoravamo in un ambiente di rete interna chiuso, con accesso esterno limitato, quindi GitLab Self-Hosted, che potevamo installare direttamente sul nostro server, era la scelta migliore. Gli strumenti possono essere diversi, ma la sostanza resta la stessa: conservare il codice e distribuirlo automaticamente.
Ho passato la notte a installare GitLab sul server e a trasferirci il codice.
“Uff, adesso se faccio di nuovo push dovrebbe distribuirsi, giusto?”
Con entusiasmo ho modificato il codice e ho lanciato git push origin master. Il codice è salito senza problemi nel repository GitLab. Ma il server di produzione non si è mosso di un millimetro. Per quanto aspettassi, la funzionalità non veniva aggiornata.
Le fatiche del deployment manuale: ritrovare il processo perduto
“Eh? Perché non viene distribuito?” Non c’era nessun senior a cui chiedere, nessun team leader su cui poter contare. Dovevo trovare la risposta da solo.
Più ci pensavo, più la cosa sembrava strana. GitLab è solo una “biblioteca che conserva il codice”. Il fatto che in biblioteca arrivi un nuovo libro non significa che appaia automaticamente sullo scaffale di una libreria, cioè del server di produzione. Prima c’era qualcosa in mezzo che si occupava di quella consegna.
“Allora devo consegnarlo io stesso?”
Ho iniziato a percorrere il processo di deployment manuale un passaggio alla volta. Era molto più complesso e seccante di quanto immaginassi.
Fase 1: test e build (Test & Build) – scartare i prodotti difettosi
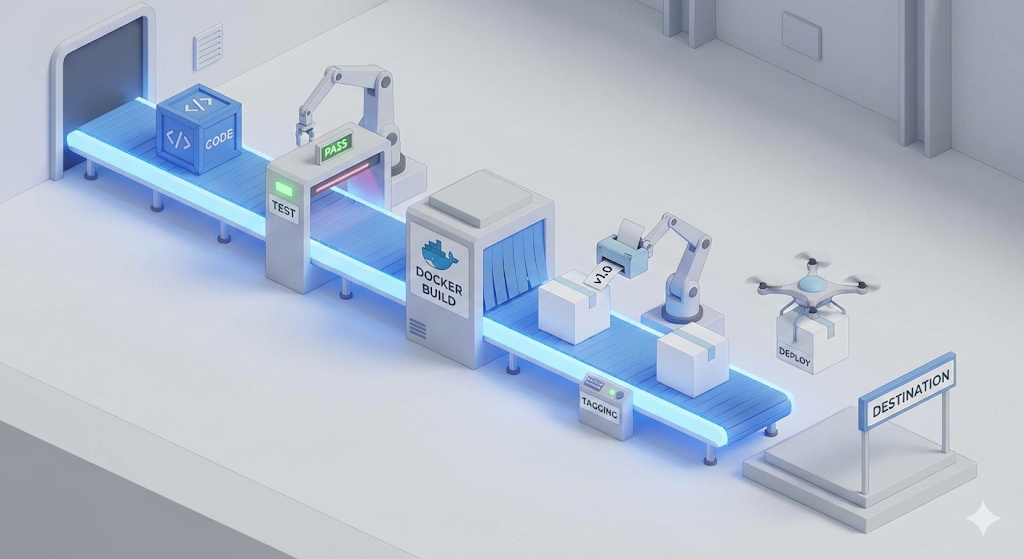
La prima cosa da fare era verificare che il codice Java sul mio computer fosse corretto e trasformarlo in qualcosa di eseguibile. Non bastava copiare i file. Dovevo controllare se il codice che avevo modificato avesse rotto la logica esistente, test, e se ci fossero errori di sintassi, build.
Ho aperto il terminale e digitato il comando: ./gradlew test clean build
È apparso un messaggio con spunte verdi che diceva che tutti i test erano passati. Per fortuna. E se qui fosse apparso un errore? Allora sarebbe stato un “prodotto difettoso”. Quel codice non doveva assolutamente arrivare sul server. Questo processo era il “primo dispositivo di sicurezza”, quello che controlla se il codice ha i requisiti minimi.
Fase 2: creazione dell’immagine (Dockerize) – congelare l’ambiente
Ora dovevo inviare quel file jar al server. Sarebbe bastato inviare solo il file? No. La serie “Works on My Machine” mi aveva insegnato sulla mia pelle che l’ambiente del mio computer, Java 17, e quello del server, Java 8, potevano essere diversi. Per questo abbiamo deciso di “congelare l’intero ambiente” e inviarlo insieme. È proprio a questo che serve Docker.
Ho creato un Dockerfile nella root del progetto e l’ho scritto con naturalezza.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Poi ho costruito l’immagine. docker build -t my-app:v1 .
Adesso il mio codice era diventato un’“immagine container” immortale, capace di girare allo stesso modo su qualsiasi server. Docker era il “secondo dispositivo di sicurezza”, quello che impediva gli errori causati dalle differenze di ambiente.
Fase 3: trasporto (Push & Pull) – usare un magazzino condiviso
L’immagine era pronta. Adesso dovevo spostarla sul server di produzione. Per fortuna “Docker Hub” non era un server interno, ma un servizio esterno su internet, cioè un SaaS. Quando l’azienda è andata in pezzi, il collegamento con GitLab nella rete interna si è spezzato, ma la strada verso la rete esterna era ancora aperta.
Con le mani tremanti, ho sparato l’immagine verso Docker Hub, il magazzino logistico condiviso.
- Caricamento dal mio computer:
docker push my-id/my-app:v1
Poco dopo è comparso il messaggio di completamento del caricamento. A quel punto era il momento di collegarsi all’altra parte, il server di produzione. Non correndo nella sala server, ma con una connessione remota sicura tramite “SSH (Secure Shell)”.
ssh user@production-server
Sullo schermo nero della CLI, ho scaricato l’immagine che avevo caricato poco prima. docker pull my-id/my-app:v1
Fase 4: deployment (Run) – sostituire il vecchio
Finalmente l’ultimo passaggio. Sul server stava già girando la vecchia versione. Dovevo fermarla e avviare quella nuova. I comandi Linux uscivano dalla punta delle dita.
- Fermare ed eliminare il container esistente:
docker stop my-app && docker rm my-app - Avviare il nuovo container:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Non appena ho premuto Invio, è comparso un lungo valore hash e, controllando i log con docker logs -f my-app, è apparso il familiare logo di Spring. Il cliente ha richiamato. “Ah? Adesso funziona bene. Grazie!”
Ma alla fine le persone sbagliano
Quel primo deployment manuale è stato un successo. Mi sono sentito pieno di fiducia. “Ma dai, si può fare anche da soli?” Però quell’arroganza non è durata a lungo. Nel ripetersi di lavori manuali, i limiti umani sono emersi molto in fretta.
Crisi 1. Un bug incontrato su un ponte strettissimo (l’assenza di branch Git)
Qualche giorno dopo stavo modificando la “funzione di login” per il cliente A quando improvvisamente il cliente B mi ha contattato dicendo che nella “funzione di pagamento” era esploso un bug critico e che andava corretto subito.
Sono andato nel panico. Usavo Git, sì, ma con la scusa che sviluppavo da solo stavo facendo tutto su un unico branch master. Il codice era già diventato un caos mescolato con le modifiche della funzione di login.
“Aspetta? Se in questo stato correggo solo il bug del pagamento e faccio deployment, salirà anche il codice incompleto del login, no?”
Alla fine ho dovuto usare un metodo primitivo: salvare in file temporanei il codice su cui stavo lavorando e tornare indietro con git reset. Nel farlo, ho persino combinato un disastro perdendo accidentalmente parte del codice.
Crisi 2. Non ho colleghi (l’assenza di test code)
Dopo mille peripezie, ho corretto il bug di pagamento e l’ho distribuito. Proprio mentre stavo per tirare un sospiro di sollievo, è arrivato un altro messaggio: ora la “registrazione” non funzionava più. Si è scoperto che, modificando la logica di pagamento, avevo toccato una funzione condivisa di validazione utente.
“Ah… se qualcuno avesse rivisto il mio codice, un Code Review, non avrei fatto questo errore.”
Ma non avevo né un senior che controllasse il mio codice né colleghi. Ero solo. In realtà, siccome avevo realizzato la funzione di registrazione in gran fretta, non avevo nemmeno scritto gli unit test. Se allora, anche se fastidioso, avessi scritto il codice di test, la macchina avrebbe acceso una spia rossa quando ho rotto la registrazione toccando la logica di pagamento.
Crisi 3. “Il server è morto!” (l’assenza di Docker tag)
E qualche giorno dopo è arrivato il colpo finale. Ho aggiunto in fretta una funzione e l’ho distribuita, ma il server è crollato per un errore di logica di business appena si è avviato. Il fatto di aver saltato i test mi si è rivoltato contro.
Le chiamate del cliente hanno iniziato a tempestarmi. “Fate rollback alla versione precedente il prima possibile!” Ho aperto il terminale del server con le mani tremanti. Ma non c’era alcun modo di tornare indietro.
Ogni volta, per pigrizia, sovrascrivevo l’immagine usando soltanto my-app:latest. Dal momento che non applicavo tag di versione separati come v1 o v2, l’immagine stabile della versione precedente era già sparita. Alla fine non mi è rimasto altro che lasciare il server fermo, tornare in locale, correggere di nuovo il codice e ricostruire tutto da zero. Ci sono voluti 10 minuti per creare l’immagine, spostarla sul server di produzione e riavviare il container, e ho persino dovuto consegnare un rapporto scritto che spiegasse come si era verificato il fermo del server.
In chiusura: il nome di tutto questo processo era la “pipeline”
Mentre scrivevo quel rapporto d’incidente in cambio di 10 minuti infernali di downtime, ho ripercorso tutto quello che avevo vissuto nei giorni precedenti.
- Git Branch: il punto di partenza per isolare e gestire il codice in sicurezza.
- Test & Code Review: il filtro che impedisce ai prodotti difettosi di passare alla fase successiva.
- Build & Dockerize: il processo che impacchetta il codice in un ambiente eseguibile.
- Docker Tag & Push: il processo che registra e conserva le versioni per ogni evenienza.
- Deploy: l’ultima fase, quella che esegue sul server un’immagine sicura.
Fino a quel momento avevo conosciuto questi processi solo come frammenti di conoscenza sparsi. A volte li saltavo perché erano seccanti. Altre volte perché non sapevo di meglio. Ma gli incidenti vissuti nel lavoro reale hanno dimostrato che ognuno di questi passaggi era un dispositivo di sicurezza essenziale che non si poteva omettere.
E ho capito che cos’era davvero quell’“automazione” che avevo cercato così a lungo. Non era semplicemente una macchina che digitava comandi al posto mio. Era il percorso che fa scorrere automaticamente i passaggi da 1 a 5 come acqua corrente, senza interruzioni e senza errori umani.
Quella era proprio la pipeline CI/CD.
“Team leader, adesso ho capito. Quello di cui abbiamo bisogno è una ‘pipeline’ in cui questi dispositivi di sicurezza funzionino automaticamente.”
La prossima volta, partendo da questo progetto, costruiamo davvero il mio robot di deployment personale, la pipeline CI/CD.