L’automazione non è qualcosa di estraneo
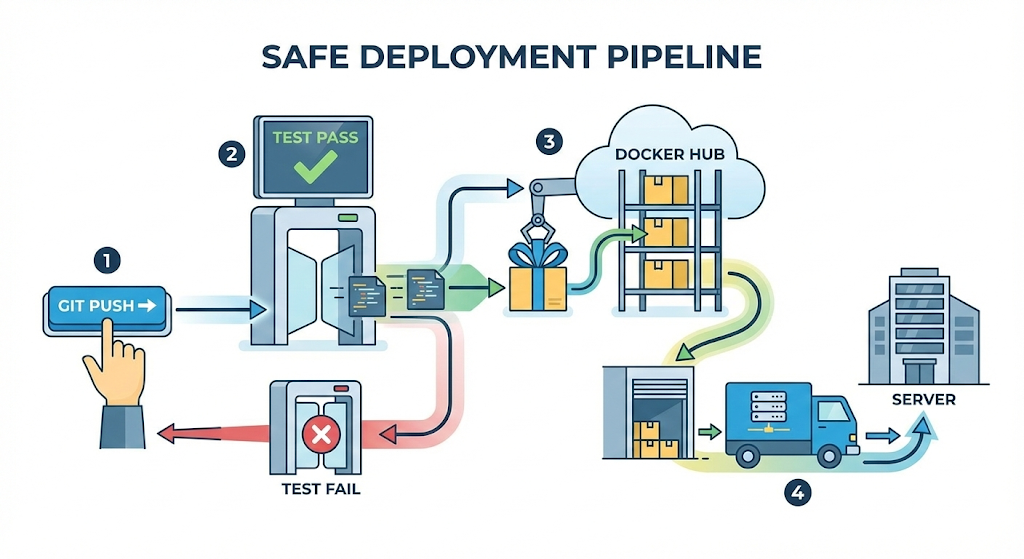
L’ultima volta ho imparato una lezione dolorosa attraverso 10 minuti di downtime e un rapporto d’incidente. Il deployment non è magia, ma deve essere una sequenza di severi dispositivi di sicurezza: “Git, registrazione – Test, verifica – Build, confezionamento – Deploy, consegna”.
Ora l’obiettivo è chiaro. Non posso continuare a controllare ogni volta con le mie mani tutti questi dispositivi di sicurezza complessi e fastidiosi. Ho bisogno di un “robot diligente” che lavori al posto mio anche dopo che ho finito la giornata o quando sono in vacanza.
“Automazione? Non è una cosa un po’ troppo grande?”
All’inizio mi spaventava, ma a pensarci bene avevo già vissuto qualcosa di simile. Era “Docker”, di cui abbiamo parlato nella serie precedente.
Quando scriviamo in un Dockerfile “installa Ubuntu, installa Java, copia il codice”, Docker lo legge e costruisce da solo l’ambiente del server. Grazie a questo, ci siamo liberati dal lavoro faticoso di digitare i comandi a mano.
Una “pipeline CI/CD” funziona allo stesso modo. Se Docker ha automatizzato la “configurazione del server”, allora la pipeline automatizza “l’intero processo di deployment”. L’unica differenza è che il palcoscenico si è ampliato: dal mio computer a un mondo più grande chiamato “GitLab e server di produzione”.
CI/CD: il nastro trasportatore automatizzato
Ora installiamo una “linea automatizzata” nel nostro “centro logistico digitale”. Sembra una cosa enorme, ma il principio è semplice.
1. CI (Continuous Integration, integrazione continua)
- Significato: “Il codice degli sviluppatori viene continuamente unito in un unico insieme e verificato.”
- Ruolo: [build + test]. È la fase in cui, appena carico il codice, la macchina controlla al posto mio: “La sintassi è corretta?”, “Le funzionalità esistenti non si sono rotte?”. I prodotti difettosi vengono scartati qui.
2. CD (Continuous Delivery/Deployment, consegna o deployment continui)
- Significato: “Il codice che ha superato i controlli viene consegnato al cliente.”
- Ruolo: [creazione dell’immagine + deployment sul server]. È la fase in cui il prodotto conforme che ha superato i controlli (Docker Image) viene caricato sul camion, spedito al server di produzione e messo in esecuzione.
Il progetto della pipeline: .gitlab-ci.yml
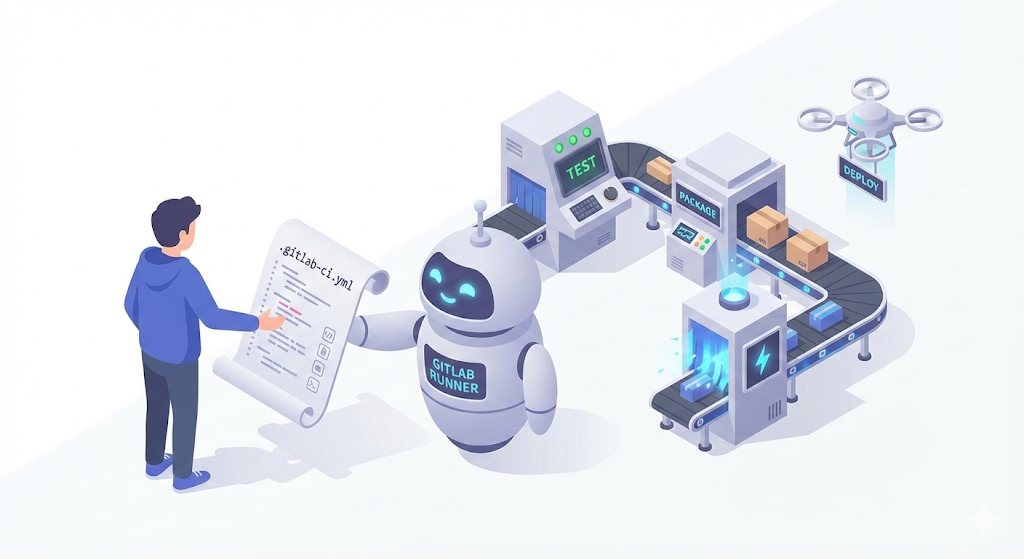
“Quindi come si fa lavorare quel robot?” In GitLab basta creare un file chiamato .gitlab-ci.yml nella radice del progetto. Quello è esattamente il “foglio di istruzioni di lavoro” da consegnare al robot.
Ricordi il dolore del deployment manuale che ho provato l’ultima volta? Trasferiamo esattamente quel processo nel codice. Proprio come quando si scrive un Dockerfile, basta metterlo giù riga per riga.
# .gitlab-ci.yml (la scheda lavoro)

stages:          # 1. Definisci l'ordine dell'intero lavoro
  - test         #   (Step 1: verifica)
  - build        #   (Step 2: pacchettizzazione)
  - deploy       #   (Step 3: spedizione)

# [Step 1] Test: macchina, controlla se il mio codice e a posto (CI)
unit_test_job:
  stage: test
  image: openjdk:17-alpine # Esegui in un ambiente con Java installato
  script:
    - ./gradlew test       # "Esegui i test!" (evita l'errore precedente)

# [Step 2] Build: se i test passano, costruisci un'immagine (CI)
build_image_job:
  stage: build
  image: docker:latest     # Esegui in un ambiente con Docker installato
  script:
    - docker build -t my-app:v1 .  # "Costruisci l'immagine!"
    - docker push my-regisry/my-app:v1 # "Pusha sul registry!" (tag di rollback obbligatorio)

# [Step 3] Deploy: ora portalo sul server di produzione (CD)
deploy_job:
  stage: deploy
  script:
    - ssh user@server "docker service update my-app" # "Aggiorna il server!"
Questo unico file è sufficiente. Nel momento in cui faccio git push, cioè al trigger, GitLab legge questo foglio di istruzioni e sveglia un robot operaio chiamato “GitLab Runner” per metterlo al lavoro.
[Check] I dispositivi di sicurezza che dobbiamo predisporre
Dentro questa pipeline sono incorporati tutti e tre i dispositivi di sicurezza che l’ultima volta ho imparato nel modo più doloroso.
- Git (Trigger):
- Il semplice fatto di fare
pushdel codice dal mio computer locale diventa il “pulsante di avvio” della pipeline. Se non resta una registrazione (Commit), non parte nemmeno il deployment.
- Il semplice fatto di fare
- Unit Test (Quality Gate):
- E se il test fallisce in
unit_test_job? La pipeline “si ferma” immediatamente (Fail). Così si impedisce alla radice che un prodotto difettoso passi alla fase successiva (build/deployment). (Ormai non si possono più saltare i test con la scusa che si ha fretta!)
- E se il test fallisce in
- Docker Image (Artifact):
- L’immagine generata nella fase di build viene conservata al sicuro su Docker Hub. Anche se un giorno il server dovesse saltare, basta questa immagine per ripristinarlo in un secondo.
Consiglio pratico: una pipeline è un organismo vivente
Non cercare di scrivere una pipeline perfetta fin dall’inizio. Anche io, all’inizio, avevo creato solo due fasi, build e deploy, e solo dopo aver combinato un incidente ho aggiunto davanti la fase di test.
- Fase iniziale: build -> deploy (l’importante, per cominciare, era automatizzare)
- Fase intermedia: test -> build -> deploy (aggiunta di un dispositivo di sicurezza)
- Fase avanzata: test -> analisi statica (SonarQube) -> build -> deploy sul server di sviluppo -> (approvazione) -> deploy sul server di produzione
Una pipeline è un “sistema vivente” che continua a evolversi insieme al ritmo di crescita del nostro team.
In chiusura: abbiamo scritto le istruzioni, ma chi lavora davvero?
Ora il progetto perfetto, .gitlab-ci.yml, è completo. Ma un foglio di istruzioni scritto sulla carta non si muove da solo. Proprio come un Dockerfile ha comunque bisogno che Docker Daemon sia installato per poter essere eseguito, anche il foglio di istruzioni della pipeline ha bisogno di un “robot operativo” che costruisca ed esegua davvero il codice sudando sul campo.
Il nome di questo robot è “GitLab Runner”. Il direttore della fabbrica, cioè il GitLab Server, si limita a dare istruzioni. Il lavoro vero viene svolto da questo runner.
La prossima volta installiamo questo runner sul mio computer o su un server separato, colleghiamolo a GitLab e facciamo partire davvero la pipeline. È finalmente il momento in cui si allaccia il primo bottone dell’automazione.