Zelfs op de dag dat het bedrijf uit elkaar viel, bleven bugfix-verzoeken binnenkomen
Zes maanden nadat ik in dienst was gekomen, op de dag dat de organisatie door de omstandigheden van het bedrijf uiteenviel en alleen ons team nog los overbleef, was het kantoor één grote chaos. Mijn teamleider zei: “Van de techniek snap ik het nu niet meer zo goed, dus jij moet alles doen”, en gaf mij de volledige verantwoordelijkheid voor het infrastructuurbeheer.
Zelfs midden in die verwarring bleef de telefoon rinkelen. Het was een klant. “Hallo, er is een fout op de inlogpagina. Wilt u dat snel oplossen?”
Mijn hoofd werd helemaal wit. Vroeger hoefde ik het alleen lokaal te fixen en een git push te doen, en dan zouden Jenkins of GitLab op de server van een andere afdeling het automatisch naar de productie-server deployen. Maar die keten was verbroken.
Nu was er geen “deployment-robot” meer die me kon helpen. Ik moest deze code met mijn eigen handen naar de productie-server brengen. Het voelde benauwend. Maar op dat moment flitsten de dingen die ik de afgelopen maanden met vallen en opstaan had geleerd door mijn hoofd.
“Wacht, rustig blijven. Als ik het principe begrijp, kan ik het ook handmatig doen. Laten we het stap voor stap veilig overzetten.”
Git en GitLab: de opslagplaats van de code
Eerst moest ik de afgebroken brug opnieuw bouwen. Het eerste wat ik nodig had, waren “Git” en “GitLab”.
- Git: een tool die mijn code opslaat en de versies (de geschiedenis) beheert. (Een tijdmachine)
- GitLab: een platform dat niet alleen de functies van een Git-repository biedt, maar ook tools voor deploymentautomatisering (CI/CD) in één geheel samenbrengt.
“Gebruiken mensen normaal niet vooral GitHub?” Dat klopt. In de praktijk wordt GitHub, inclusief GitHub Actions, het meest gebruikt, en sommige teams zetten daarnaast ook de traditionele krachtpatser Jenkins apart op.
Maar wij werkten in een gesloten intern netwerk met beperkte externe toegang, dus GitLab Self-Hosted, dat we direct op onze eigen server konden installeren, was de beste keuze. De tools verschillen misschien, maar de essentie is overal dezelfde: code opslaan en automatisch uitrollen.
Ik haalde een nacht door om GitLab op de server te installeren en de code te verplaatsen.
“Pfoe, als ik nu weer push, wordt het dan wel gedeployed?”
Vol verwachting paste ik de code aan en vuurde git push origin master af. De code kwam netjes in de GitLab-repository terecht. Maar de productie-server gaf geen krimp. Hoe lang ik ook wachtte, de functie werd niet bijgewerkt.
Het geploeter van handmatig deployen: het verdwenen proces terugvinden
“Huh? Waarom wordt dit niet gedeployed?” Er was geen senior aan wie ik het kon vragen, geen teamleider op wie ik kon leunen. Ik moest zelf het antwoord vinden.
Hoe langer ik erover nadacht, hoe vreemder het leek. GitLab is gewoon een “bibliotheek die code opslaat”. Het feit dat er een nieuw boek in een bibliotheek binnenkomt, betekent nog niet dat het automatisch op de plank van een boekwinkel, dus de productie-server, verschijnt. Vroeger zat er iets tussen dat die bezorging deed.
“Moet ik het dan zelf gaan bezorgen?”
Ik begon het handmatige deploymentproces stap voor stap te doorlopen. Het was veel ingewikkelder en vervelender dan ik had verwacht.
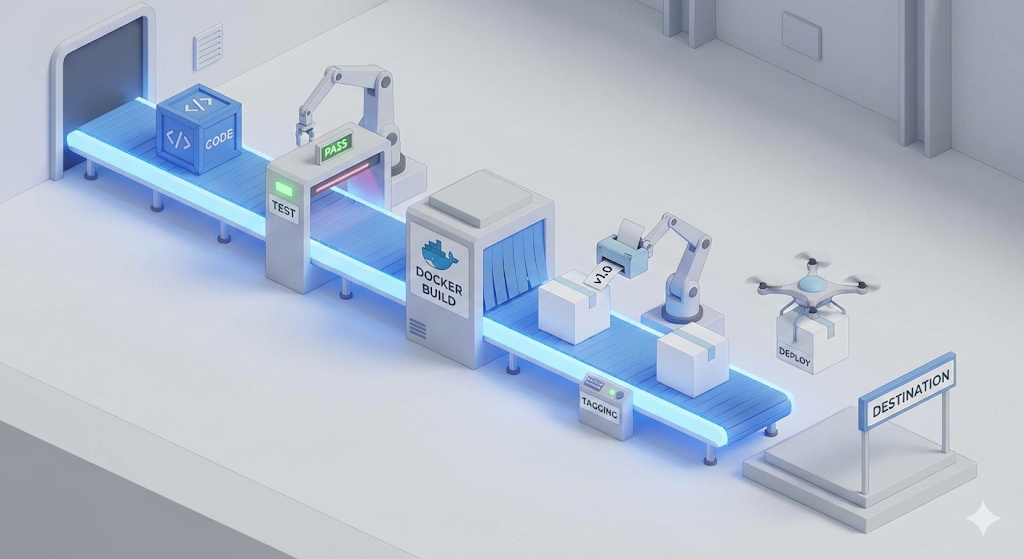
Stap 1: testen en builden (Test & Build) – ondeugdelijke producten eruit filteren
Het eerste wat ik moest doen, was controleren of de Java-code op mijn computer in orde was en die in een uitvoerbare staat brengen. Alleen bestanden kopiëren was niet genoeg. Ik moest nagaan of de code die ik had aangepast de bestaande logica had gebroken, test, en of er syntaxfouten waren, build.
Ik opende de terminal en typte het commando: ./gradlew test clean build
Er verscheen een bericht met groene vinkjes dat alle tests waren geslaagd. Gelukkig maar. Wat als hier een fout was verschenen? Dan was het een “ondeugdelijk product” geweest. Zulke code mocht niet naar de server. Dit proces was het “eerste veiligheidsmechanisme”, dat controleert of de code aan de minimale eisen voldoet.
Stap 2: image maken (Dockerize) – de omgeving bevriezen
Nu moest ik dat jar-bestand naar de server sturen. Was het genoeg om alleen het bestand te verzenden? Nee. De serie “Works on My Machine” had me hard geleerd dat de omgeving van mijn computer, Java 17, en die van de server, Java 8, van elkaar konden verschillen. Daarom besloten we de hele omgeving “in te vriezen” en zo te versturen. Daar is Docker voor.
Ik maakte een Dockerfile in de projectroot en schreef die zonder aarzeling uit.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Daarna bakte ik de image. docker build -t my-app:v1 .
Mijn code was nu een onsterfelijke “container-image” geworden die op elke server hetzelfde zou draaien. Docker was het “tweede veiligheidsmechanisme”, dat fouten door omgevingsverschillen voorkwam.
Stap 3: transport (Push & Pull) – een gedeeld magazijn gebruiken
De image was klaar. Nu moest ik die naar de productie-server brengen. Gelukkig was “Docker Hub” geen interne bedrijfsserver, maar een externe internetdienst, dus SaaS. Toen het bedrijf uit elkaar viel, werd de GitLab-verbinding in het interne netwerk verbroken, maar de weg naar het externe netwerk lag nog open.
Met trillende handen stuurde ik de image naar Docker Hub, het gedeelde logistieke magazijn.
- Uploaden vanaf mijn computer:
docker push my-id/my-app:v1
Even later verscheen het bericht dat de upload voltooid was. Nu was het tijd om verbinding te maken met de andere kant: de productie-server. Niet door naar de serverruimte te rennen, maar door veilig op afstand in te loggen via “SSH (Secure Shell)”.
ssh user@production-server
Op het zwarte scherm van de CLI haalde ik de eerder geüploade image binnen. docker pull my-id/my-app:v1
Stap 4: deployment (Run) – vervangen
Eindelijk de laatste stap. Op de server draaide de oude versie al. Die moest ik stoppen en de nieuwe versie starten. De Linux-commando’s rolden van mijn vingertoppen.
- De bestaande container stoppen en verwijderen:
docker stop my-app && docker rm my-app - De nieuwe container starten:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Zodra ik op Enter drukte, verscheen er een lange hashwaarde en toen ik met docker logs -f my-app de logs controleerde, kwam het vertrouwde Spring-logo tevoorschijn. Daarna belde de klant terug. “Hè? Nu werkt het goed. Bedankt!”
Maar uiteindelijk maken mensen fouten
Die eerste handmatige deployment was een succes. Ik zat vol zelfvertrouwen. “Wat is dit nou? In mijn eentje lukt het ook wel.” Maar die overmoed hield niet lang stand. In herhaald handwerk werden menselijke grenzen snel zichtbaar.
Crisis 1. Een bug op een smalle brug (het ontbreken van Git-branches)
Een paar dagen later was ik de “loginfunctie” voor klant A aan het aanpassen, toen klant B me plotseling liet weten dat er een kritieke bug was ontploft in de “betaalfunctie” en dat die onmiddellijk gerepareerd moest worden.
Ik raakte in paniek. Ik gebruikte Git wel, maar omdat ik mezelf voorhield dat ik toch alleen ontwikkelde, deed ik al het werk op één enkele master-branch. De code was al een enorme warboel geworden door alle wijzigingen voor de loginfunctie.
“Wacht eens, als ik in deze staat alleen de betaalbug fix en deploy, gaat dan de onvoltooide logincode ook mee omhoog?”
Uiteindelijk moest ik terugvallen op een primitieve methode: de code waar ik aan werkte tijdelijk opslaan in bestanden en de code terugdraaien met git reset. Daarbij veroorzaakte ik zelfs een ramp door per ongeluk een deel van de code kwijt te raken.
Crisis 2. Ik heb geen collega’s (het ontbreken van testcode)
Na veel omwegen had ik de betaalbug opgelost en gedeployed. Net toen ik wilde uitademen, kwam er weer een melding binnen: nu werkte de “registratie” niet meer. Het bleek dat ik bij het aanpassen van de betaallogica een gedeelde gebruikersvalidatiefunctie had aangeraakt.
“Ah… als iemand mijn code had nagekeken, een Code Review, had ik deze fout niet gemaakt.”
Maar ik had geen senior die mijn code kon reviewen en ook geen collega. Ik stond er alleen voor. Eigenlijk had ik voor de registratiefunctie, omdat alles zo hectisch ging, niet eens unit tests geschreven. Als ik toen, hoe vervelend ook, testcode had gemaakt, had de machine rood licht gegeven toen ik de registratie brak door aan de betaallogica te zitten.
Crisis 3. “De server is dood!” (het ontbreken van Docker-tags)
En een paar dagen later kwam de genadeklap. Ik had haastig een functie toegevoegd en gedeployed, maar zodra de server opstartte, crashte hij door een fout in de businesslogica. Het overslaan van tests brak me op.
De klant begon me te bestoken met telefoontjes. “Rollback alsjeblieft zo snel mogelijk naar de vorige versie!” Met trillende handen opende ik de serverterminal. Maar er was geen enkele manier om terug te draaien.
Omdat ik versiebeheer iedere keer gedoe vond, overschreef ik de image steeds alleen met my-app:latest. Omdat ik geen aparte versietags zoals v1 of v2 toevoegde, was de stabiele image van de vorige versie al verdwenen. Uiteindelijk moest ik de stilgevallen server achterlaten, lokaal de code opnieuw repareren en alles vanaf nul opnieuw bouwen. Het duurde 10 minuten om de image te maken, naar de productie-server te verplaatsen en de container opnieuw te starten, en bovendien moest ik een schriftelijk incidentrapport inleveren over hoe de uitval was ontstaan.
Tot slot: de naam van dit hele proces was “pipeline”
Terwijl ik dat incidentrapport schreef in ruil voor 10 helse minuten downtime, keek ik terug op alles wat ik de afgelopen dagen had meegemaakt.
- Git Branch: het startpunt om code veilig te isoleren en te beheren.
- Test & Code Review: de zeef die voorkomt dat ondeugdelijke producten doorschuiven naar de volgende stap.
- Build & Dockerize: het proces waarin de code samen met een uitvoerbare omgeving wordt verpakt.
- Docker Tag & Push: het proces waarin versies worden vastgelegd en opgeslagen voor het geval dat er iets misgaat.
- Deploy: de laatste stap, waarin een veilige image op de server wordt uitgevoerd.
Tot dan toe kende ik deze processen alleen als losse stukjes kennis. Soms sloeg ik ze over omdat ik ze irritant vond. Soms omdat ik niet beter wist. Maar de incidenten die ik in de praktijk meemaakte, bewezen dat al deze stappen essentiële veiligheidsmechanismen waren die je niet kunt overslaan.
En toen begreep ik wat die “automatisering” waar ik zo wanhopig naar had gezocht eigenlijk was. Het was niet simpelweg een machine die commando’s voor mij intypte. Het was het pad dat stap 1 tot en met 5 soepel als stromend water, zonder onderbrekingen en zonder menselijke fouten automatisch laat doorlopen.
Dat was precies de CI/CD-pipeline.
“Teamleider, nu snap ik het. Wat wij nodig hebben, is een ‘pipeline’ waarin deze veiligheidsmechanismen automatisch draaien.”
Laten we de volgende keer, op basis van dit ontwerp, mijn eigen deployment-robot echt bouwen: de CI/CD-pipeline.