Même le jour où l’entreprise s’est désintégrée, les demandes de correction de bugs ont continué d’arriver
Six mois après mon arrivée, le jour où l’organisation s’est volatilisée à cause de la situation de l’entreprise et où seule notre équipe est restée isolée, le bureau était en plein chaos. Mon chef d’équipe m’a dit : « Moi, la technique, je ne comprends plus très bien, donc maintenant tu dois tout faire », et il m’a confié l’autorité complète sur la gestion de l’infrastructure.
Même au milieu de cette confusion, le téléphone n’arrêtait pas de sonner. C’était un client. « Excusez-moi, il y a une erreur sur la page de connexion. Merci de corriger ça rapidement. »
J’ai senti mon esprit se vider. Avant, si je corrigeais ça en local et que je faisais simplement un git push, Jenkins ou GitLab, hébergé sur le serveur d’un autre service, déployait automatiquement sur le serveur de production. Mais ce maillon-là s’était rompu.
Il n’y avait plus aucun « robot de déploiement » pour m’aider. Je devais amener ce code jusqu’au serveur de production de mes propres mains. C’était étouffant. Mais à ce moment-là, les connaissances que j’avais acquises au prix de nombreux chocs au cours des derniers mois ont traversé mon esprit.
« Attends, calme-toi. Si je comprends les principes, je peux le faire manuellement aussi. Déplaçons-le en sécurité, une étape à la fois. »
Git et GitLab : l’entrepôt du code
Je devais d’abord reconstruire le pont coupé. Les premières choses dont j’avais besoin étaient « Git » et « GitLab ».
- Git : l’outil qui stocke mon code et gère ses versions, c’est-à-dire son historique. (Une machine à remonter le temps)
- GitLab : une plateforme qui, en plus des fonctions de dépôt Git, réunit en un seul endroit les outils d’automatisation du déploiement (CI/CD).
« En général, on n’utilise pas surtout GitHub ? » C’est vrai. Dans la pratique la plus répandue, c’est GitHub, avec GitHub Actions, qui est le plus utilisé, et certaines équipes montent aussi séparément le grand classique, Jenkins.
Mais nous étions dans un environnement de réseau interne fermé, avec un accès extérieur limité. GitLab Self-Hosted, que nous pouvions installer directement sur notre propre serveur, était donc le meilleur choix. Les outils diffèrent, mais l’essentiel reste le même : stocker le code et le déployer automatiquement.
J’ai passé la nuit à installer GitLab sur le serveur et à y transférer le code.
« Ouf, maintenant, si je refais un push, ça devrait être déployé, non ? »
Avec excitation, j’ai modifié le code et lancé git push origin master. Le code est bien monté dans le dépôt GitLab. Mais le serveur de production n’a pas bougé. J’ai eu beau attendre, la fonctionnalité n’a jamais été mise à jour.
Les galères du déploiement manuel : retrouver le processus disparu
« Hein ? Pourquoi ça ne se déploie pas ? » Il n’y avait aucun senior à qui demander, aucun chef d’équipe sur qui m’appuyer. Je devais trouver la réponse tout seul.
En y réfléchissant bien, c’était étrange. GitLab n’est qu’une « bibliothèque qui stocke du code ». Ce n’est pas parce qu’un nouveau livre entre dans une bibliothèque qu’il apparaît automatiquement sur l’étagère d’une librairie, c’est-à-dire le serveur de production. Avant, quelque chose au milieu assurait cette livraison.
« Alors il faut que je livre moi-même ? »
J’ai commencé à suivre le processus de déploiement manuel étape par étape. C’était bien plus complexe et pénible que je ne l’imaginais.
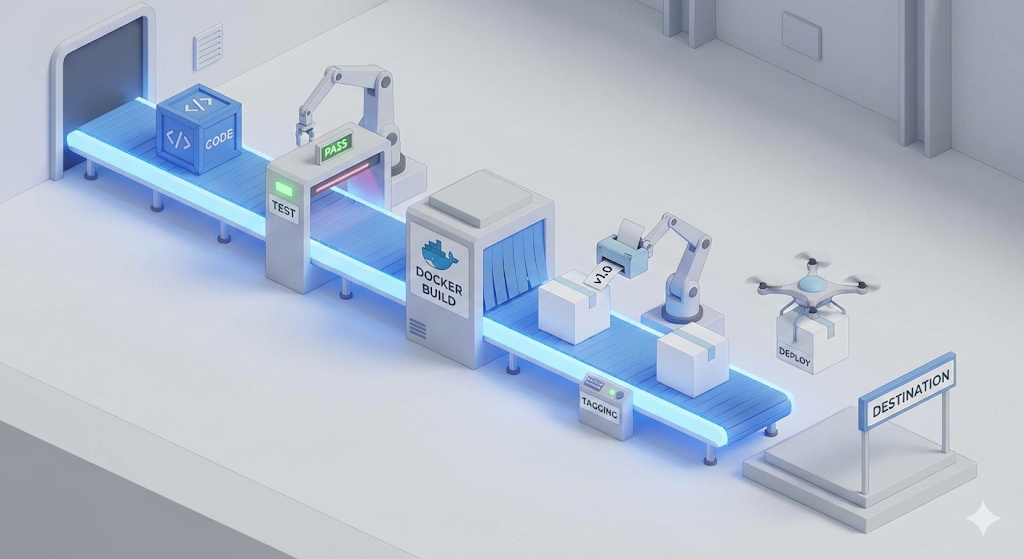
Étape 1 : test et build (Test & Build) – écarter les produits défectueux
La première chose à faire était de vérifier que le code Java sur mon ordinateur était correct et de le rendre exécutable. Il ne suffisait pas de copier des fichiers. Il fallait vérifier si le code que j’avais modifié n’avait pas cassé la logique existante, test, et s’il n’y avait pas d’erreurs de syntaxe, build.
J’ai ouvert le terminal et saisi la commande : ./gradlew test clean build
Un message accompagné de coches vertes est apparu : tous les tests étaient passés. Heureusement. Et si une erreur était apparue ici ? Cela aurait été un « produit défectueux ». Un code pareil ne doit pas monter sur le serveur. Cette étape était le « premier garde-fou », celui qui vérifie que le code remplit les qualifications minimales.
Étape 2 : création d’image (Dockerize) – figer l’environnement
Je devais ensuite envoyer ce fichier jar au serveur. Est-ce qu’il suffisait d’envoyer seulement le fichier ? Non. La série « Works on My Machine » me l’avait appris durement : l’environnement de mon ordinateur, Java 17, et celui du serveur, Java 8, pouvaient être différents. Nous avons donc décidé d’« envoyer l’environnement tout entier gelé ». C’est précisément le rôle de Docker.
J’ai créé un Dockerfile à la racine du projet et je l’ai rédigé naturellement.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Puis j’ai construit l’image. docker build -t my-app:v1 .
Mon code était désormais devenu une « image de conteneur » immortelle, capable de tourner de la même manière sur n’importe quel serveur. Docker était le « deuxième garde-fou », celui qui empêchait les erreurs dues aux différences d’environnement.
Étape 3 : transport (Push & Pull) – utiliser un entrepôt partagé
L’image était prête. Il fallait maintenant la déplacer vers le serveur de production. Heureusement, « Docker Hub » n’était pas un serveur interne, mais un service externe sur internet, c’est-à-dire un SaaS. Quand l’entreprise s’est désintégrée, la liaison GitLab du réseau interne a été coupée, mais le chemin vers le réseau extérieur restait ouvert.
Les mains tremblantes, j’ai envoyé l’image vers Docker Hub, l’entrepôt logistique partagé.
- Envoi depuis mon ordinateur :
docker push my-id/my-app:v1
Peu après, le message annonçant la fin de l’envoi est apparu. Il était temps de passer de l’autre côté, sur le serveur de production. Pas en courant dans la salle des serveurs, mais par une connexion distante sécurisée via « SSH (Secure Shell) ».
ssh user@production-server
Sur l’écran noir connecté, la CLI, j’ai récupéré l’image que j’avais envoyée un peu plus tôt. docker pull my-id/my-app:v1
Étape 4 : déploiement (Run) – remplacer l’existant
Enfin la dernière étape. L’ancienne version du serveur tournait déjà. Il fallait l’arrêter et démarrer la nouvelle. Les commandes Linux sortaient du bout de mes doigts.
- Arrêter et supprimer le conteneur existant :
docker stop my-app && docker rm my-app - Lancer le nouveau conteneur :
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Dès que j’ai appuyé sur Entrée, une longue valeur de hachage s’est affichée et, en vérifiant les logs avec docker logs -f my-app, le logo familier de Spring est apparu. Le client a rappelé. « Ah ? Maintenant ça fonctionne bien. Merci ! »
Mais au final, l’humain finit toujours par se tromper
Ce premier déploiement manuel a été un succès. J’étais plein de confiance. « Quoi, même tout seul, c’est faisable ? » Mais cette arrogance n’a pas duré. Dans des tâches manuelles répétées, les limites humaines apparaissent très vite.
Crise 1. Un bug rencontré sur un pont étroit (l’absence de branches Git)
Quelques jours plus tard, je corrigeais la « fonctionnalité de connexion » pour le client A lorsque le client B m’a soudainement contacté : un bug critique venait d’exploser dans la « fonctionnalité de paiement » et il fallait le corriger immédiatement.
J’ai paniqué. J’utilisais bien Git, mais sous prétexte que je développais seul, je faisais tout sur une seule branche master. Le code était déjà devenu un véritable bazar mêlant les modifications de la fonctionnalité de connexion.
« Attends ? Si je corrige seulement le bug de paiement et que je déploie dans cet état, le code de connexion encore inachevé va partir avec, non ? »
Finalement, j’ai dû recourir à une méthode primitive : sauvegarder le code en cours dans des fichiers temporaires et revenir en arrière avec git reset. Au passage, j’ai même provoqué une catastrophe en perdant accidentellement une partie du code.
Crise 2. Je n’ai pas de collègues (l’absence de code de test)
Après bien des péripéties, j’ai corrigé le bug de paiement et je l’ai déployé. Au moment où j’allais souffler, un autre message est arrivé : désormais, « l’inscription » ne fonctionnait plus. En réalité, en modifiant la logique de paiement, j’avais touché une fonction de validation utilisateur partagée.
« Ah… si quelqu’un avait relu mon code, un Code Review, je n’aurais pas commis ce genre d’erreur. »
Mais je n’avais ni senior pour relire mon code, ni collègue. J’étais seul. En réalité, comme j’avais développé la fonctionnalité d’inscription dans l’urgence, je n’avais même pas écrit de tests unitaires. Si j’avais pris la peine de préparer des tests à ce moment-là, la machine aurait allumé un voyant rouge lorsque j’ai cassé l’inscription en touchant à la logique de paiement.
Crise 3. « Le serveur est mort ! » (l’absence de tags Docker)
Et quelques jours plus tard, le coup fatal est arrivé. J’ai ajouté une fonctionnalité à la hâte et je l’ai déployée, mais le serveur s’est effondré dès son démarrage à cause d’une erreur de logique métier. Le fait d’avoir sauté les tests m’était revenu en pleine figure.
Les appels des clients se sont mis à pleuvoir. « Merci de revenir rapidement à la version précédente ! » J’ai ouvert le terminal du serveur avec les mains tremblantes. Mais il n’y avait aucun moyen de faire un rollback.
À chaque fois, par flemme, j’écrasais simplement l’image avec my-app:latest. Comme je n’avais jamais appliqué de tags de version distincts comme v1 ou v2, l’image stable de la version précédente avait déjà disparu. Au final, il n’y avait plus qu’à laisser le serveur planté derrière moi, corriger le code à nouveau en local et tout reconstruire depuis le début. Il a fallu 10 minutes pour recréer l’image, la transférer au serveur de production et redémarrer le conteneur, et j’ai même dû remettre un rapport écrit expliquant comment l’incident était survenu.
En conclusion : le nom de tout ce processus, c’était la « pipeline »
En rédigeant ce rapport d’incident en échange de 10 minutes d’enfer sous forme de downtime, je suis revenu sur tout ce que j’avais vécu ces derniers jours.
- Git Branch : le point de départ pour isoler et gérer le code en toute sécurité.
- Test & Code Review : le filtre qui empêche les produits défectueux de passer à l’étape suivante.
- Build & Dockerize : le processus qui emballe le code dans un environnement exécutable.
- Docker Tag & Push : le processus qui consigne et conserve chaque version en prévision du pire.
- Deploy : la dernière étape, qui exécute une image sûre sur le serveur.
Jusqu’alors, je ne connaissais ces processus que comme des fragments de savoir dispersés. Parfois, je les sautais parce qu’ils m’ennuyaient. Parfois, parce que je ne savais pas mieux. Mais les incidents que j’avais vécus dans le travail réel ont prouvé que chacune de ces étapes était un garde-fou essentiel qu’on ne pouvait pas omettre.
Et j’ai compris ce qu’était réellement cette « automatisation » que j’avais tant cherchée. Ce n’était pas simplement une machine qui tapait des commandes à ma place. C’était la voie qui permet aux étapes 1 à 5 de s’enchaîner comme de l’eau qui coule, sans interruption et sans erreur humaine.
C’était précisément la pipeline CI/CD.
« Chef, maintenant j’ai compris. Ce qu’il nous faut, c’est une “pipeline” dans laquelle ces garde-fous fonctionnent automatiquement. »
La prochaine fois, en partant de ce plan, construisons réellement mon propre robot de déploiement, la pipeline CI/CD.