Automatisierung ist nichts Fremdes
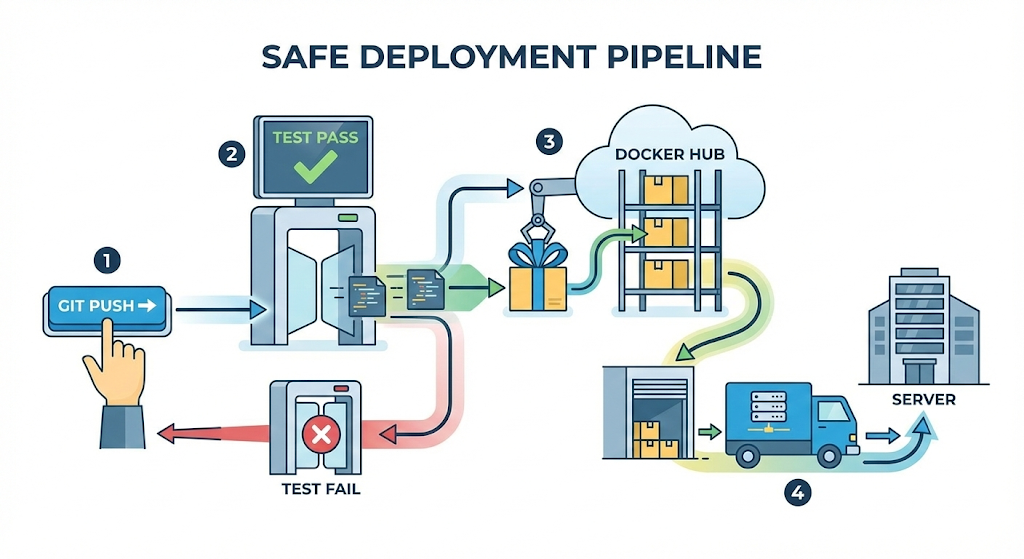
Letztes Mal habe ich durch 10 Minuten Downtime und einen Vorfallsbericht eine bittere Lektion gelernt. Deployment ist keine Magie, sondern muss aus einer Kette strenger Sicherheitsvorrichtungen bestehen: „Git, Aufzeichnung – Test, Prüfung – Build, Verpackung – Deploy, Auslieferung“.
Jetzt ist das Ziel klar. Diese komplexen und lästigen Sicherheitsvorrichtungen kann ich nicht jedes Mal mit meinen eigenen Händen prüfen. Ich brauche einen fleißigen Roboter, der auch dann für mich arbeitet, wenn ich Feierabend habe oder im Urlaub bin.
„Automatisierung? Ist das nicht ein bisschen zu groß gedacht?“
Am Anfang hatte ich erst einmal Angst. Doch je länger ich darüber nachdachte, desto mehr fiel mir auf, dass ich so etwas Ähnliches bereits erlebt hatte. Nämlich „Docker“, das wir in der letzten Serie behandelt haben.
Wenn wir in ein Dockerfile schreiben: „Ubuntu installieren, Java installieren, Code kopieren“, dann liest Docker das und baut die Serverumgebung selbstständig auf. Dadurch wurden wir von der mühsamen Handarbeit befreit, Befehle manuell einzutippen.
Eine „CI/CD-Pipeline“ funktioniert genauso. Wenn Docker die „Server-Einrichtung“ automatisiert hat, dann automatisiert die Pipeline „den gesamten Deployment-Prozess“. Nur die Bühne ist von meinem Rechner auf eine größere Welt namens „GitLab und Produktivserver“ erweitert worden.
CI/CD: das automatisierte Förderband
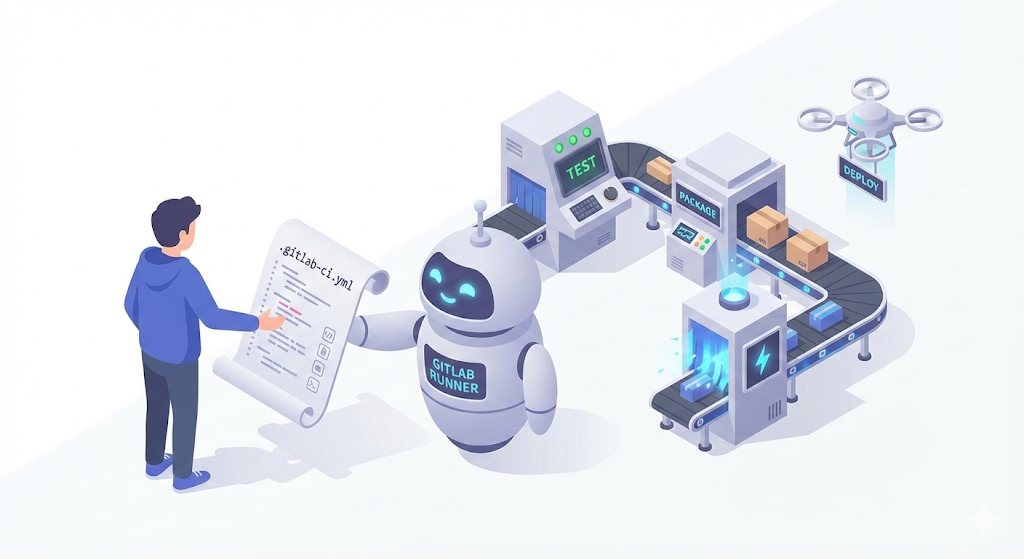
Installieren wir nun eine „Automatisierungslinie“ in unserem „digitalen Logistikzentrum“. Es klingt groß, aber das Prinzip ist einfach.
1. CI (Continuous Integration, kontinuierliche Integration)
- Bedeutung: „Den Code der Entwickler fortlaufend zusammenführen und prüfen.“
- Rolle: [Build + Test]. Sobald ich Code hochlade, prüft die Maschine für mich: „Stimmt die Syntax?“, „Ist keine bestehende Funktion kaputtgegangen?“ In dieser Stufe wird Ausschuss aussortiert.
2. CD (Continuous Delivery/Deployment, kontinuierliches Ausliefern/Deployen)
- Bedeutung: „Den fertig geprüften Code an den Kunden ausliefern.“
- Rolle: [Image-Erstellung + Server-Deployment]. In dieser Stufe wird das einwandfreie Produkt, das die Prüfung bestanden hat (Docker Image), auf den Lkw geladen, zum Produktivserver gebracht und dort auch gestartet.
Der Bauplan der Pipeline: .gitlab-ci.yml
„Und wie bringt man diesem Roboter nun bei, was er tun soll?“ In GitLab reicht es aus, im obersten Projektpfad eine Datei namens .gitlab-ci.yml anzulegen. Das ist genau die „Arbeitsanweisung“, die man dem Roboter gibt.
Erinnern Sie sich an den Schmerz des manuellen Deployments, den ich letztes Mal erlebt habe? Genau diesen Prozess übertragen wir jetzt in Code. So wie beim Schreiben eines Dockerfile trägt man Zeile für Zeile ein.
# .gitlab-ci.yml (Arbeitsanweisung)

stages:          # 1. Reihenfolge der gesamten Arbeit definieren
  - test         #   (Stufe 1: Pruefung)
  - build        #   (Stufe 2: Verpacken)
  - deploy       #   (Stufe 3: Lieferung)

# [Stufe 1] Test: Maschine, pruefe bitte, ob mein Code in Ordnung ist (CI)
unit_test_job:
  stage: test
  image: openjdk:17-alpine # In einer Umgebung mit Java ausfuehren
  script:
    - ./gradlew test       # "Tests ausfuehren!" (vermeidet den letzten Fehler)

# [Stufe 2] Build: wenn die Tests bestanden sind, ein Image bauen (CI)
build_image_job:
  stage: build
  image: docker:latest     # In einer Umgebung mit Docker ausfuehren
  script:
    - docker build -t my-app:v1 .  # "Image backen!"
    - docker push my-regisry/my-app:v1 # "In die Registry hochladen!" (Rollback-Tag erforderlich)

# [Stufe 3] Deploy: bring es jetzt auf den Produktionsserver (CD)
deploy_job:
  stage: deploy
  script:
    - ssh user@server "docker service update my-app" # "Server aktualisieren!"
Diese eine Datei genügt. In dem Moment, in dem ich ein git push ausführe, also beim Trigger, liest GitLab diese Anweisung und weckt einen Arbeitsroboter namens „GitLab Runner“, damit er die Aufgabe ausführt.
[Check] Die Sicherheitsvorrichtungen, um die wir uns kümmern müssen
In dieser Pipeline sind alle drei Sicherheitsvorrichtungen enthalten, die ich letztes Mal schmerzhaft gelernt habe.
- Git (Trigger):
- Schon das
pushmeines Codes vom lokalen Rechner ist der „Startknopf“ der Pipeline. Ohne Aufzeichnung (Commit) startet auch kein Deployment.
- Schon das
- Unit Test (Quality Gate):
- Was passiert, wenn der Test in
unit_test_jobfehlschlägt? Dann „stoppt“ die Pipeline sofort (Fail). So wird von vornherein verhindert, dass Ausschuss in die nächste Stufe (Build/Deploy) gelangt. (Tests weglassen, nur weil man es eilig hat, geht jetzt nicht mehr!)
- Was passiert, wenn der Test in
- Docker Image (Artifact):
- Das in der Build-Stufe erzeugte Image wird sicher in Docker Hub gespeichert. Selbst wenn der Server später abstürzt, lässt er sich mit diesem Image in 1 Sekunde wiederherstellen.
Praxistipp: Eine Pipeline ist ein lebendes Wesen
Versuchen Sie nicht, von Anfang an eine perfekte Pipeline zu schreiben. Ich selbst habe anfangs nur die beiden Stufen build und deploy erstellt und erst nach einem Zwischenfall die test-Stufe davor ergänzt.
- Anfangsphase: Build -> Deploy (Hauptsache, es ist erst einmal automatisiert)
- Mittlere Phase: Test -> Build -> Deploy (Sicherheitsvorrichtung ergänzt)
- Ausbaustufe: Test -> statische Analyse (SonarQube) -> Build -> Deployment auf den Entwicklungsserver -> (Freigabe) -> Deployment auf den Produktivserver
Eine Pipeline ist ein „lebendes System“, das sich mit der Wachstumsgeschwindigkeit unseres Teams ständig weiterentwickelt.
Zum Schluss: Die Anweisung ist geschrieben, aber wer arbeitet eigentlich?
Jetzt ist der perfekte Bauplan, .gitlab-ci.yml, fertig. Aber eine auf Papier geschriebene Anweisung bewegt sich nicht von selbst. Genauso wie ein Dockerfile nur dann ausgeführt werden kann, wenn der Docker-Daemon installiert ist, braucht auch eine Pipeline-Anweisung einen „Roboter im Außendienst“, der tatsächlich schwitzend den Code baut und ausführt.
Der Name dieses Roboters ist „GitLab Runner“. Der Fabrikleiter, also der GitLab Server, gibt nur Anweisungen. Die eigentliche Arbeit führt dieser Runner aus.
Nächstes Mal installieren wir diesen Runner auf meinem Rechner oder auf einem separaten Server, koppeln ihn mit GitLab und lassen die Pipeline wirklich laufen. Das ist endlich der Moment, in dem der erste Knopf der Automatisierung geschlossen wird.