Ein Satz, der mehr bewirkt als jedes Konzeptpapier: „Zeigen Sie es mir einfach mal“
Als ich bei einem SI-Projekt (Systemintegration, also Auftragsentwicklung) für eine öffentliche Einrichtung plötzlich die gesamte Entwicklung allein stemmen musste, war die größte Hürde nicht die Technik. Es war die „Ungewissheit“. Die ideale Umgebung, in der nach einem sorgfältig ausgearbeiteten Lastenheft entworfen wird, gab es nicht. Die zuständigen Ansprechpartner auf Kundenseite hatten wenig Ahnung von Softwareentwicklung und wussten oft nicht einmal, was sie eigentlich wollten, bevor sie die Oberfläche mit eigenen Augen gesehen hatten.
„Hm, auf dem Bild kann ich mir das nicht so richtig vorstellen … Kann ich das nicht mal selbst anklicken?“
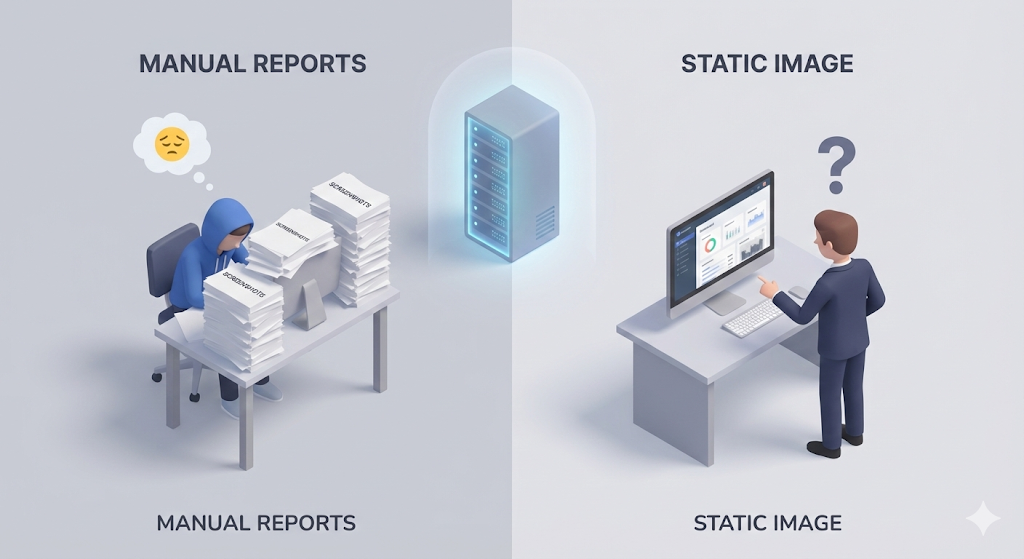
Jedes Mal, wenn ich eine Funktion gebaut hatte, startete ich sie lokal (auf meinem eigenen Rechner), machte Screenshots, versah sie mit rotem Stift mit Anmerkungen, packte alles in eine „Berichtsdatei“ (HWP/PPT; HWP ist das in Korea verbreitete Textverarbeitungsformat) und schickte sie per Mail. Doch mit statischen Bildern allein ließ sich der Ansprechpartner nicht zufriedenstellen.
„Ach, die Funktion von vorhin war doch besser. Machen Sie das bitte wieder rückgängig.“ „Was passiert, wenn man auf diesen Button klickt? Nehmen Sie das bitte als Video auf.“
Gestern hieß es noch, A sei gut, heute soll es B sein. Lokal den Code ändern, neue Screenshots machen, den Bericht schreiben: eine Endlosschleife. Das Schreiben der Berichte dauerte länger als die Entwicklung selbst. Da wedelte der Schwanz mit dem Hund.
Da wurde mir schmerzlich klar: „Ich brauche keine Screenshots von meinem Bildschirm, die ich verschicke. Ich brauche einen Spielplatz (einen Entwicklungsserver), auf den der Ansprechpartner selbst gehen kann, um nach Herzenslust herumzuklicken und auch mal etwas kaputt zu machen.“
Chancen kommen unverhofft: Die Wiederentdeckung eines verwaisten Servers
Wie es der Zufall wollte, wurde unserem Team bei der Aufspaltung des Unternehmens ein ungenutzter Server (ein leerer Rechner) zugeteilt. Die Hardware war alles andere als üppig, aber es lief Linux darauf, und er hatte eine öffentliche IP-Adresse: eine wertvolle Ressource.
„Chef, darf ich den übrigen Server benutzen? Ich würde ihn gern als Server einrichten, auf dem unser Ansprechpartner alles selbst prüfen kann.“
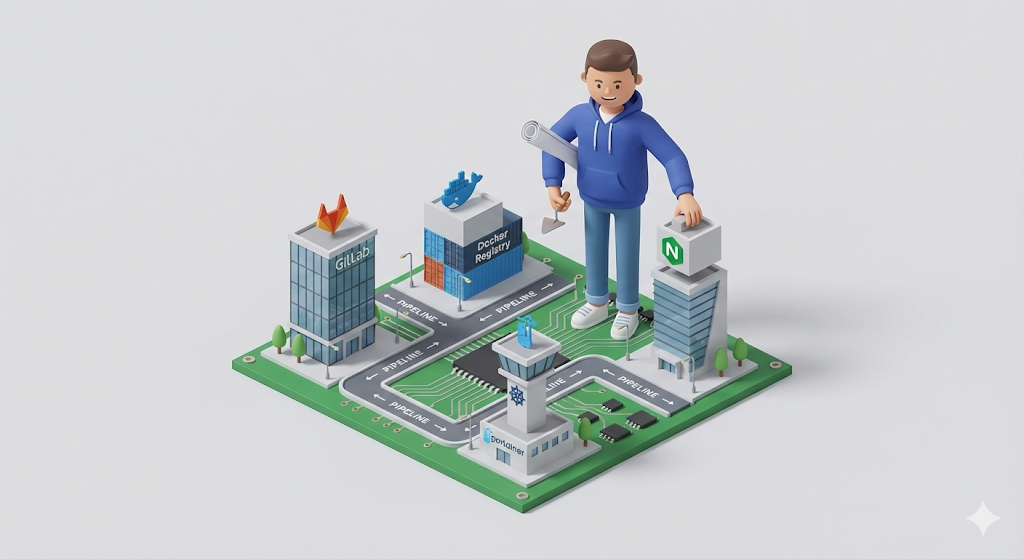
Die Erlaubnis kam. Ich steckte alles, was ich bis dahin gelernt hatte, in diese leere Blechkiste und begann, mein „eigenes kleines Infrastruktur-Imperium“ zu errichten. Es war die Summe meiner mühsamen Bastelei der letzten Monate (der Serien Works on My Machine & The Pipeline).
- GitLab (Code-Repository): Ich installiere ein privates Repository und verwalte den Code dort sicher.
- Docker Registry (Image-Speicher): Ich baue unser eigenes Lager, in dem die gebauten Docker-Images liegen.
- Portainer (Container-Verwaltung): Damit kann ich, der sich vor der CLI fürchtet, Docker über eine GUI verwalten.
- Nginx (Webserver): Ich stelle einen Pförtner auf, der die Anfragen an Frontend und Backend wie ein Verkehrspolizist in geordnete Bahnen lenkt.
Die Lösung: Vollständige Trennung der Umgebungen (Dev vs Prod)
Jetzt hatte ich zwei Bühnen (Server). Um die Launen des Ansprechpartners aufzufangen und trotzdem den Produktivserver zu schützen, habe ich meine Deployment-Strategie aufgeteilt.
- Entwicklungsserver (Development): „Ein Labor für freie Experimente“
- Der Ansprechpartner kommt gar nicht erst dazu, zu fragen: „Ist das schon fertig?“
- Sobald Code im Branch
developlandet, läuft sofort die Pipeline an und es wird automatisch deployt. - Der Ansprechpartner kann jederzeit die URL des Entwicklungsservers aufrufen, die Funktionen testen und Feedback geben.
- Produktivserver (Production): „Das geprüfte Heiligtum“
- Deployt wird nur, wenn der Ansprechpartner erklärt: „Diese Funktion ist endgültig abgenommen!“
- Der Code wird in den Branch
masterzusammengeführt (Merge), und deployt wird erst, wenn ich in GitLab den „Freigabe-Button“ drücke (Manual).
[Code Verification] Ordnung schaffen mit bedingtem Deployment
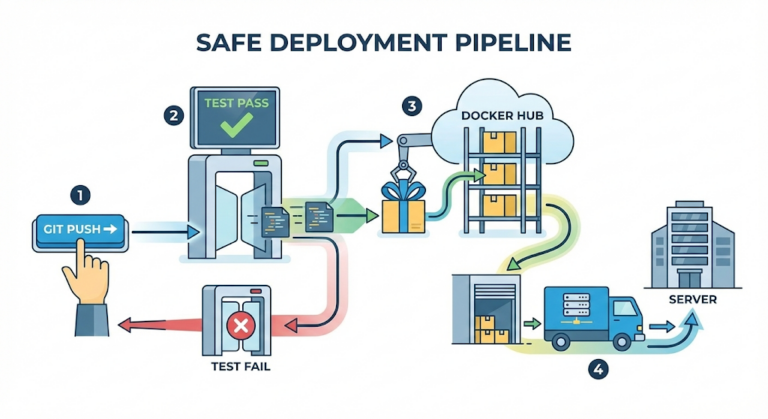
In GitLab CI lässt sich für jeden Branch ein eigener Deployment-Weg festlegen. Als Code umgesetzt sieht diese Strategie so aus:
stages:
  - build
  - deploy

# 1. Build (gemeinsam)
build_job:
  stage: build
  script:
    - ./gradlew build
    - docker build -t my-reg/app:$CI_COMMIT_SHA .
    - docker push my-reg/app:$CI_COMMIT_SHA

# 2. Deployment auf den Entwicklungsserver (automatisch)
# Sobald Code im Branch 'develop' landet, wird ohne Wenn und Aber deployt.
deploy_to_dev:
  stage: deploy
  script:
    - ssh user@dev-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-dev"
  only:
    - develop

# 3. Deployment auf den Produktivserver (manuelle Freigabe)
# Auch wenn Code im Branch 'master' landet, wird erst deployt, wenn ich den Button drücke.
deploy_to_prod:
  stage: deploy
  script:
    - ssh user@prod-server "docker service update --image my-reg/app:$CI_COMMIT_SHA app-prod"
  only:
    - master
  when: manual # Das Entscheidende! Läuft nur, 'wenn ein Mensch den Button drückt'.
Die wichtigsten Punkte:
only: - develop: Der Entwicklungs-Branch wird ausnahmslos automatisch deployt. Hier ist Tempo alles.when: manual: Der Produktiv-Branch bekommt eine Sicherung, denn ein Mensch prüft noch einmal und drückt erst dann auf den Knopf.
Zum Schluss: Endlich komplett – „Ich lebe allein“ in der Entwickler-Edition
Jetzt habe sogar ich als Solo-Entwickler ein perfektes System.
- Lokal: Entwicklung der Funktionen auf meinem eigenen Rechner.
- Entwicklung (Dev): Ein einziges
git push, und fünf Minuten später ist alles auf dem Entwicklungsserver. Der Ansprechpartner prüft selbst. - Produktion (Prod): Nur abgenommene Funktionen werden gesammelt und sicher mit einem einzigen Klick deployt.
Die Zeiten, in denen ich als Neuling Überstunden machte, das Screenshot-Tool startete und Anmerkungen in HWP-Dateien tippte, sind vorbei. Wenn der Ansprechpartner sagt: „Können Sie das bitte ändern?“, antworte ich: „Klar, ist angepasst und liegt auf dem Entwicklungsserver, schauen Sie es sich gern an“, und trinke ganz entspannt meinen Kaffee. Denn jetzt arbeitet das System für mich.
Damit fällt der Vorhang für das lange Projekt [Re: Booting]. Von den Informatik-Grundlagen über Linux und Docker bis hin zur CI/CD-Pipeline. Ich hoffe, dass dieses Wissen, das ich mir ohne jede Anleitung mühsam erarbeitet habe, all den „Full-Stack-Entwicklern aus purer Notwendigkeit“, die sich gerade irgendwo allein durchkämpfen, ein kleines Licht auf dem Weg ist.