Selbst an dem Tag, an dem die Firma in sich zusammenfiel, kamen noch Bugfix-Anfragen
Sechs Monate nach meinem Eintritt, an dem Tag, an dem die Organisation aus firmeninternen Gründen auseinanderfiel und nur unser Team übrig blieb, herrschte im Büro Chaos. Mein Teamleiter sagte: „Von Technik verstehe ich inzwischen nicht mehr viel, das musst du jetzt alles übernehmen“, und übergab mir die volle Verantwortung für das Infrastruktur-Management.
Mitten in diesem Durcheinander klingelte das Telefon weiter. Es war ein Kunde. „Entschuldigung, auf der Login-Seite tritt ein Fehler auf. Bitte beheben Sie das schnell.“
Mir wurde ganz weiß vor Augen. Früher hätte ich es lokal behoben und einfach ein git push gemacht, und Jenkins oder GitLab auf dem Server einer anderen Abteilung hätten es automatisch auf den Produktivserver ausgerollt. Aber diese Kette war gerissen.
Jetzt gab es keinen „Deployment-Roboter“ mehr, der mir half. Ich musste diesen Code mit meinen eigenen Händen bis auf den Produktivserver bringen. Es war beklemmend. Doch in diesem Moment huschten mir die Dinge durch den Kopf, die ich in den vergangenen Monaten mühsam gelernt hatte, indem ich mich durch jedes Problem selbst hindurchgearbeitet hatte.
„Moment, bleib ruhig. Wenn ich das Prinzip verstehe, kann ich es auch manuell machen. Bringen wir es Schritt für Schritt sicher rüber.“
Git und GitLab: das Lager für den Code
Zuerst musste ich die abgebrochene Brücke wieder aufbauen. Das Erste, was ich brauchte, waren „Git“ und „GitLab“.
- Git: Ein Werkzeug, das meinen Code speichert und seine Versionen, also seine Geschichte, verwaltet. (Eine Zeitmaschine)
- GitLab: Eine Plattform, die nicht nur die Funktionen eines Git-Repositorys bietet, sondern auch Werkzeuge zur Deployment-Automatisierung (CI/CD) unter einem Dach vereint.
„Benutzt man normalerweise nicht eher GitHub?“ Stimmt. Im Mainstream wird am häufigsten GitHub mit GitHub Actions verwendet, und manche Teams setzen zusätzlich den traditionellen Platzhirsch Jenkins auf.
Aber wir arbeiteten in einem abgeschotteten internen Netzwerk mit eingeschränktem externem Zugriff, daher war GitLab Self-Hosted, das wir direkt auf unserem eigenen Server installieren konnten, die beste Wahl. Die Werkzeuge mögen unterschiedlich sein, doch das Wesen ist überall gleich: Code speichern und automatisch ausrollen.
Ich machte die Nacht durch, installierte GitLab auf dem Server und zog den Code um.
„Puh, wenn ich jetzt wieder pushe, wird es wohl deployt, oder?“
Voller Vorfreude änderte ich den Code und schickte git push origin master ab. Im GitLab-Repository landete der Code sauber. Doch der Produktivserver bewegte sich keinen Millimeter. Egal wie lange ich wartete, die Funktion wurde nicht aktualisiert.
Mühsame manuelle Deployments: den verlorenen Ablauf wiederfinden
„Hä? Warum wird das nicht ausgerollt?“ Es gab keinen Senior, den ich fragen konnte, keinen Teamleiter, auf den ich mich verlassen konnte. Ich musste die Antwort selbst finden.
Je länger ich darüber nachdachte, desto merkwürdiger wurde es. GitLab ist nur eine „Bibliothek, die Code aufbewahrt“. Nur weil ein neues Buch in der Bibliothek angekommen ist, liegt es ja nicht automatisch im Regal des Buchladens, also des Produktivservers. Früher hatte irgendetwas dazwischen diese Lieferung übernommen.
„Dann muss ich wohl selbst liefern?“
Ich begann, den manuellen Deployment-Prozess Schritt für Schritt selbst durchzugehen. Es war viel komplizierter und lästiger, als ich gedacht hatte.
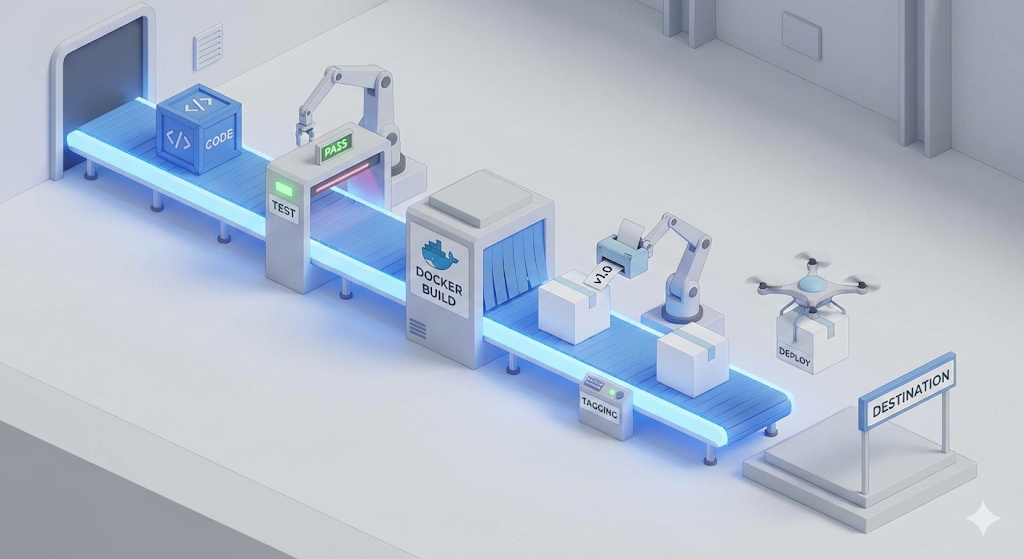
Schritt 1: Test & Build – Ausschuss aussortieren
Als Erstes musste ich prüfen, ob der Java-Code auf meinem Rechner in Ordnung war, und ihn in einen ausführbaren Zustand bringen. Dateien einfach zu kopieren reichte nicht. Ich musste kontrollieren, ob mein geänderter Code die bestehende Logik beschädigt hatte (Test) und ob Syntaxfehler vorhanden waren (Build).
Ich öffnete das Terminal und tippte den Befehl ein: ./gradlew test clean build
Zusammen mit grünen Häkchen erschien die Meldung, dass alle Tests bestanden waren. Zum Glück. Was wäre, wenn hier ein Fehler aufgetreten wäre? Dann wäre das „Ausschuss“. Solcher Code darf nicht auf den Server. Dieser Schritt war die „erste Sicherheitsvorrichtung“, die prüfte, ob der Code die Mindestanforderungen erfüllt.
Schritt 2: Image-Erstellung (Dockerize) – die Umgebung konservieren
Jetzt musste ich diese jar-Datei zum Server schicken. Reichte es, einfach nur die Datei zu senden? Nein. In der Serie „Works on My Machine“ hatte ich schmerzhaft gelernt, dass die Umgebungen meines Rechners, Java 17, und des Servers, Java 8, unterschiedlich sein können. Deshalb beschlossen wir, „die ganze Umgebung einzufrieren“ und so zu versenden. Genau dafür ist Docker da.
Ich legte im Projektwurzelverzeichnis ein Dockerfile an und schrieb es routiniert herunter.
FROM openjdk:17-alpine
COPY build/libs/my-app.jar app.jar
ENTRYPOINT ["java", "-jar", "app.jar"]
Dann baute ich das Image. docker build -t my-app:v1 .
Mein Code war nun zu einem unsterblichen „Container-Image“ geworden, das auf jedem Server gleich laufen würde. Docker war die „zweite Sicherheitsvorrichtung“, die Fehler durch Umgebungsunterschiede verhinderte.
Schritt 3: Transport (Push & Pull) – ein gemeinsames Lager nutzen
Das Image war bereit. Jetzt musste ich es auf den Produktivserver bringen. Zum Glück war Docker Hub kein interner Firmenserver, sondern ein externer Internetdienst, also SaaS. Als die Firma zerfiel, wurde die GitLab-Verbindung im internen Netz zwar gekappt, aber der Weg ins externe Netz war noch offen.
Mit zitternden Händen schoss ich das Image in Docker Hub hoch, das gemeinsame Logistiklager.
- Upload von meinem Rechner:
docker push my-id/my-app:v1
Kurz darauf erschien die Meldung, dass der Upload abgeschlossen sei. Jetzt war es Zeit, die andere Seite zu betreten, den Produktivserver. Nicht, indem ich in den Serverraum rannte, sondern per sicherer Fernverbindung über „SSH (Secure Shell)“.
ssh user@production-server
Auf dem schwarzen Bildschirm, der CLI, zog ich das zuvor hochgeladene Image herunter. docker pull my-id/my-app:v1
Schritt 4: Deployment (Run) – austauschen
Endlich der letzte Schritt. Auf dem Server lief bereits die alte Version. Die musste ich stoppen und die neue Version starten. Die Linux-Befehle liefen mir von den Fingern.
- Bestehenden Container stoppen und löschen:
docker stop my-app && docker rm my-app - Neuen Container starten:
docker run -d --name my-app -p 80:8080 my-id/my-app:v1
Sobald ich Enter drückte, erschien ein langer Hash-Wert, und als ich mit docker logs -f my-app die Logs prüfte, tauchte das vertraute Spring-Logo auf. Dann rief der Kunde erneut an. „Oh? Jetzt funktioniert es. Vielen Dank!“
Aber am Ende macht der Mensch doch Fehler
Das erste manuelle Deployment war erfolgreich. Ich war voller Selbstvertrauen. „Was soll’s, allein geht das doch auch.“ Aber diese Überheblichkeit hielt nicht lange. In der sich wiederholenden Handarbeit zeigten sich menschliche Grenzen sehr schnell.
Krise 1. Ein Bug auf dem schmalen Steg (fehlende Git-Branches)
Ein paar Tage später arbeitete ich auf Wunsch von Kunde A an der „Login-Funktion“, als plötzlich Kunde B meldete, in der „Bezahlfunktion“ sei ein kritischer Fehler aufgetreten und müsse sofort behoben werden.
Ich geriet in Panik. Ich nutzte zwar Git, arbeitete aber mit der Ausrede, dass ich ja allein entwickle, nur auf einem einzigen master-Branch. Der Code war bereits ein Durcheinander aus Änderungen an der Login-Funktion.
„Moment mal? Wenn ich in diesem Zustand nur den Zahlungs-Bug behebe und deploye, geht dann nicht auch der unfertige Login-Code mit hoch?“
Am Ende musste ich zu einer primitiven Methode greifen: den in Arbeit befindlichen Code in temporären Dateien sichern und den Code mit git reset zurücksetzen. Dabei passierte mir sogar das Unglück, dass ich versehentlich Teile des Codes verlor.
Krise 2. Ich habe keine Kollegen (fehlender Test-Code)
Nach allerlei Mühen hatte ich den Zahlungs-Bug behoben und deployt. Gerade als ich aufatmen wollte, kam die nächste Meldung: Jetzt funktionierte die Registrierung nicht mehr. Wie sich herausstellte, hatte ich beim Ändern der Zahlungslogik eine gemeinsam genutzte Benutzer-Validierungsfunktion angefasst.
„Ach… wenn jemand meinen Code gegengelesen hätte, also ein Code Review, wäre mir dieser Fehler nicht passiert.“
Aber ich hatte keinen Senior, der meinen Code prüfte, und auch keinen Kollegen. Ich war allein. Tatsächlich hatte ich für die Registrierungsfunktion wegen des hektischen Tempos nicht einmal Unit Tests geschrieben. Hätte ich damals die Mühe auf mich genommen, Testcode zu schreiben, hätte die Maschine Alarm geschlagen, als ich durch die Änderung der Zahlungslogik die Registrierung zerstörte.
Krise 3. „Der Server ist tot!“ (fehlende Docker-Tags)
Und ein paar Tage später kam der entscheidende Schlag. Ich hatte hastig eine Funktion ergänzt und deployt, doch kaum war der Server gestartet, stürzte er wegen eines Business-Logik-Fehlers ab. Dass ich die Tests ausgelassen hatte, rächte sich.
Die Anrufe der Kunden prasselten auf mich ein. „Bitte rollen Sie sofort auf die vorige Version zurück!“ Mit zitternden Händen öffnete ich das Server-Terminal. Aber es gab keine Möglichkeit zum Rollback.
Weil mir Versionierung jedes Mal lästig vorkam, hatte ich das Image immer nur als my-app:latest überschrieben. Da ich nie separate Versions-Tags wie v1 oder v2 vergeben hatte, war das stabile Image der vorherigen Version bereits verschwunden. Am Ende blieb mir nichts anderes übrig, als den gestoppten Server hinter mir zu lassen, lokal den Code erneut zu korrigieren und wieder von vorne zu bauen. Es dauerte 10 Minuten, das Image zu erstellen, auf den Produktivserver zu übertragen und den Container neu zu starten, und ich musste einen schriftlichen Vorfallsbericht über den Ablauf des Serverausfalls verfassen.
Zum Schluss: Der Name für all das war „Pipeline“
Während ich diesen Vorfallsbericht als Gegenleistung für 10 höllische Minuten Downtime schrieb, ließ ich die vergangenen Tage noch einmal Revue passieren.
- Git Branch: Der Ausgangspunkt, um Code sicher zu isolieren und zu verwalten.
- Test & Code Review: Das Sieb, das verhindert, dass Ausschuss in die nächste Stufe gelangt.
- Build & Dockerize: Der Schritt, in dem der Code in eine lauffähige Umgebung verpackt wird.
- Docker Tag & Push: Der Schritt, in dem Versionen für den Notfall festgehalten und gespeichert werden.
- Deploy: Der letzte Schritt, in dem ein sicheres Image auf dem Server ausgeführt wird.
Bis dahin kannte ich diese Abläufe nur als voneinander getrennte Wissensfragmente. Manchmal ließ ich sie aus Bequemlichkeit weg. Manchmal übersprang ich sie aus Unwissenheit. Doch die Vorfälle in der Praxis bewiesen, dass jeder einzelne dieser Schritte eine unverzichtbare Sicherheitsvorrichtung ist, die nicht fehlen darf.
Und ich begriff, was die „Automatisierung“ war, nach der ich so verzweifelt gesucht hatte. Es war nicht bloß eine Maschine, die Befehle für mich eintippt. Es war der Weg, der die Schritte eins bis fünf wie fließendes Wasser ohne Unterbrechung und ohne menschliche Fehler automatisch weiterlaufen lässt.
Genau das war die CI/CD-Pipeline.
„Teamleiter, jetzt verstehe ich es. Was wir brauchen, ist eine ‚Pipeline‘, in der diese Sicherheitsvorrichtungen automatisch laufen.“
Beim nächsten Mal bauen wir auf dieser Blaupause auf und richten meinen eigenen Deployment-Roboter, die CI/CD-Pipeline, wirklich ein.